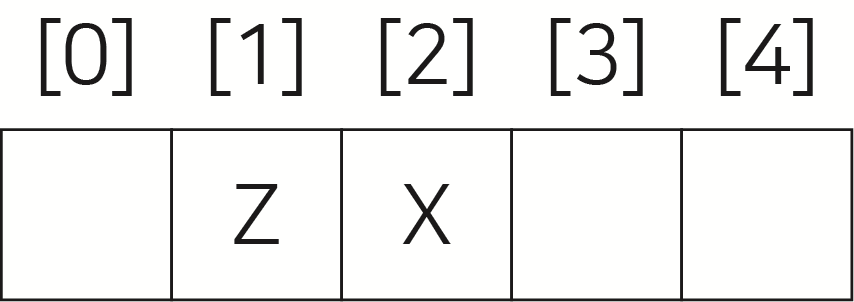7급 국가직 알고리즘 2025년 기출문제

시행 2025-09-20 · 책형 가 · 25문항 · 출처: 인사혁신처 공개 기출(공공데이터포털, 이용허락 제한 없음)

전체 풀기 (시험 모드)원본 PDF 받기2025 7급 국가직 전과목
1.
알고리즘의 조건에 대한 설명으로 옳지 않은 것은?
알고리즘
  1. ①입력: 외부에서 제공되는 자료가 0개 이상이어야 한다.
  2. ②출력: 적어도 1개 이상의 결과를 만들어야 한다.
  3. ③명확성: 명령어들은 현재 실행 가능한 연산이어야 한다.
  4. ④유한성: 한정된 수의 단계 후에는 반드시 종료되어야 한다.
정답 보기

정답 ③ · 해설 보기

2.
점근 표기법에 대한 설명으로 옳은 것은?
알고리즘
  1. ①알고리즘의 수행 시간을 대략적으로 나타내는 방법이다.
  2. ②(Big-oh) 표기는 최소한의 알고리즘 수행 시간을 나타내기 위해 사용한다.
  3. ③n개 정수 배열에 대한 순차 탐색 알고리즘은 (1) 시간 복잡도를 가진다.
  4. ④증가 함수 는 으로 표기할 수 있다.
정답 보기

정답 ① · 해설 보기

3.
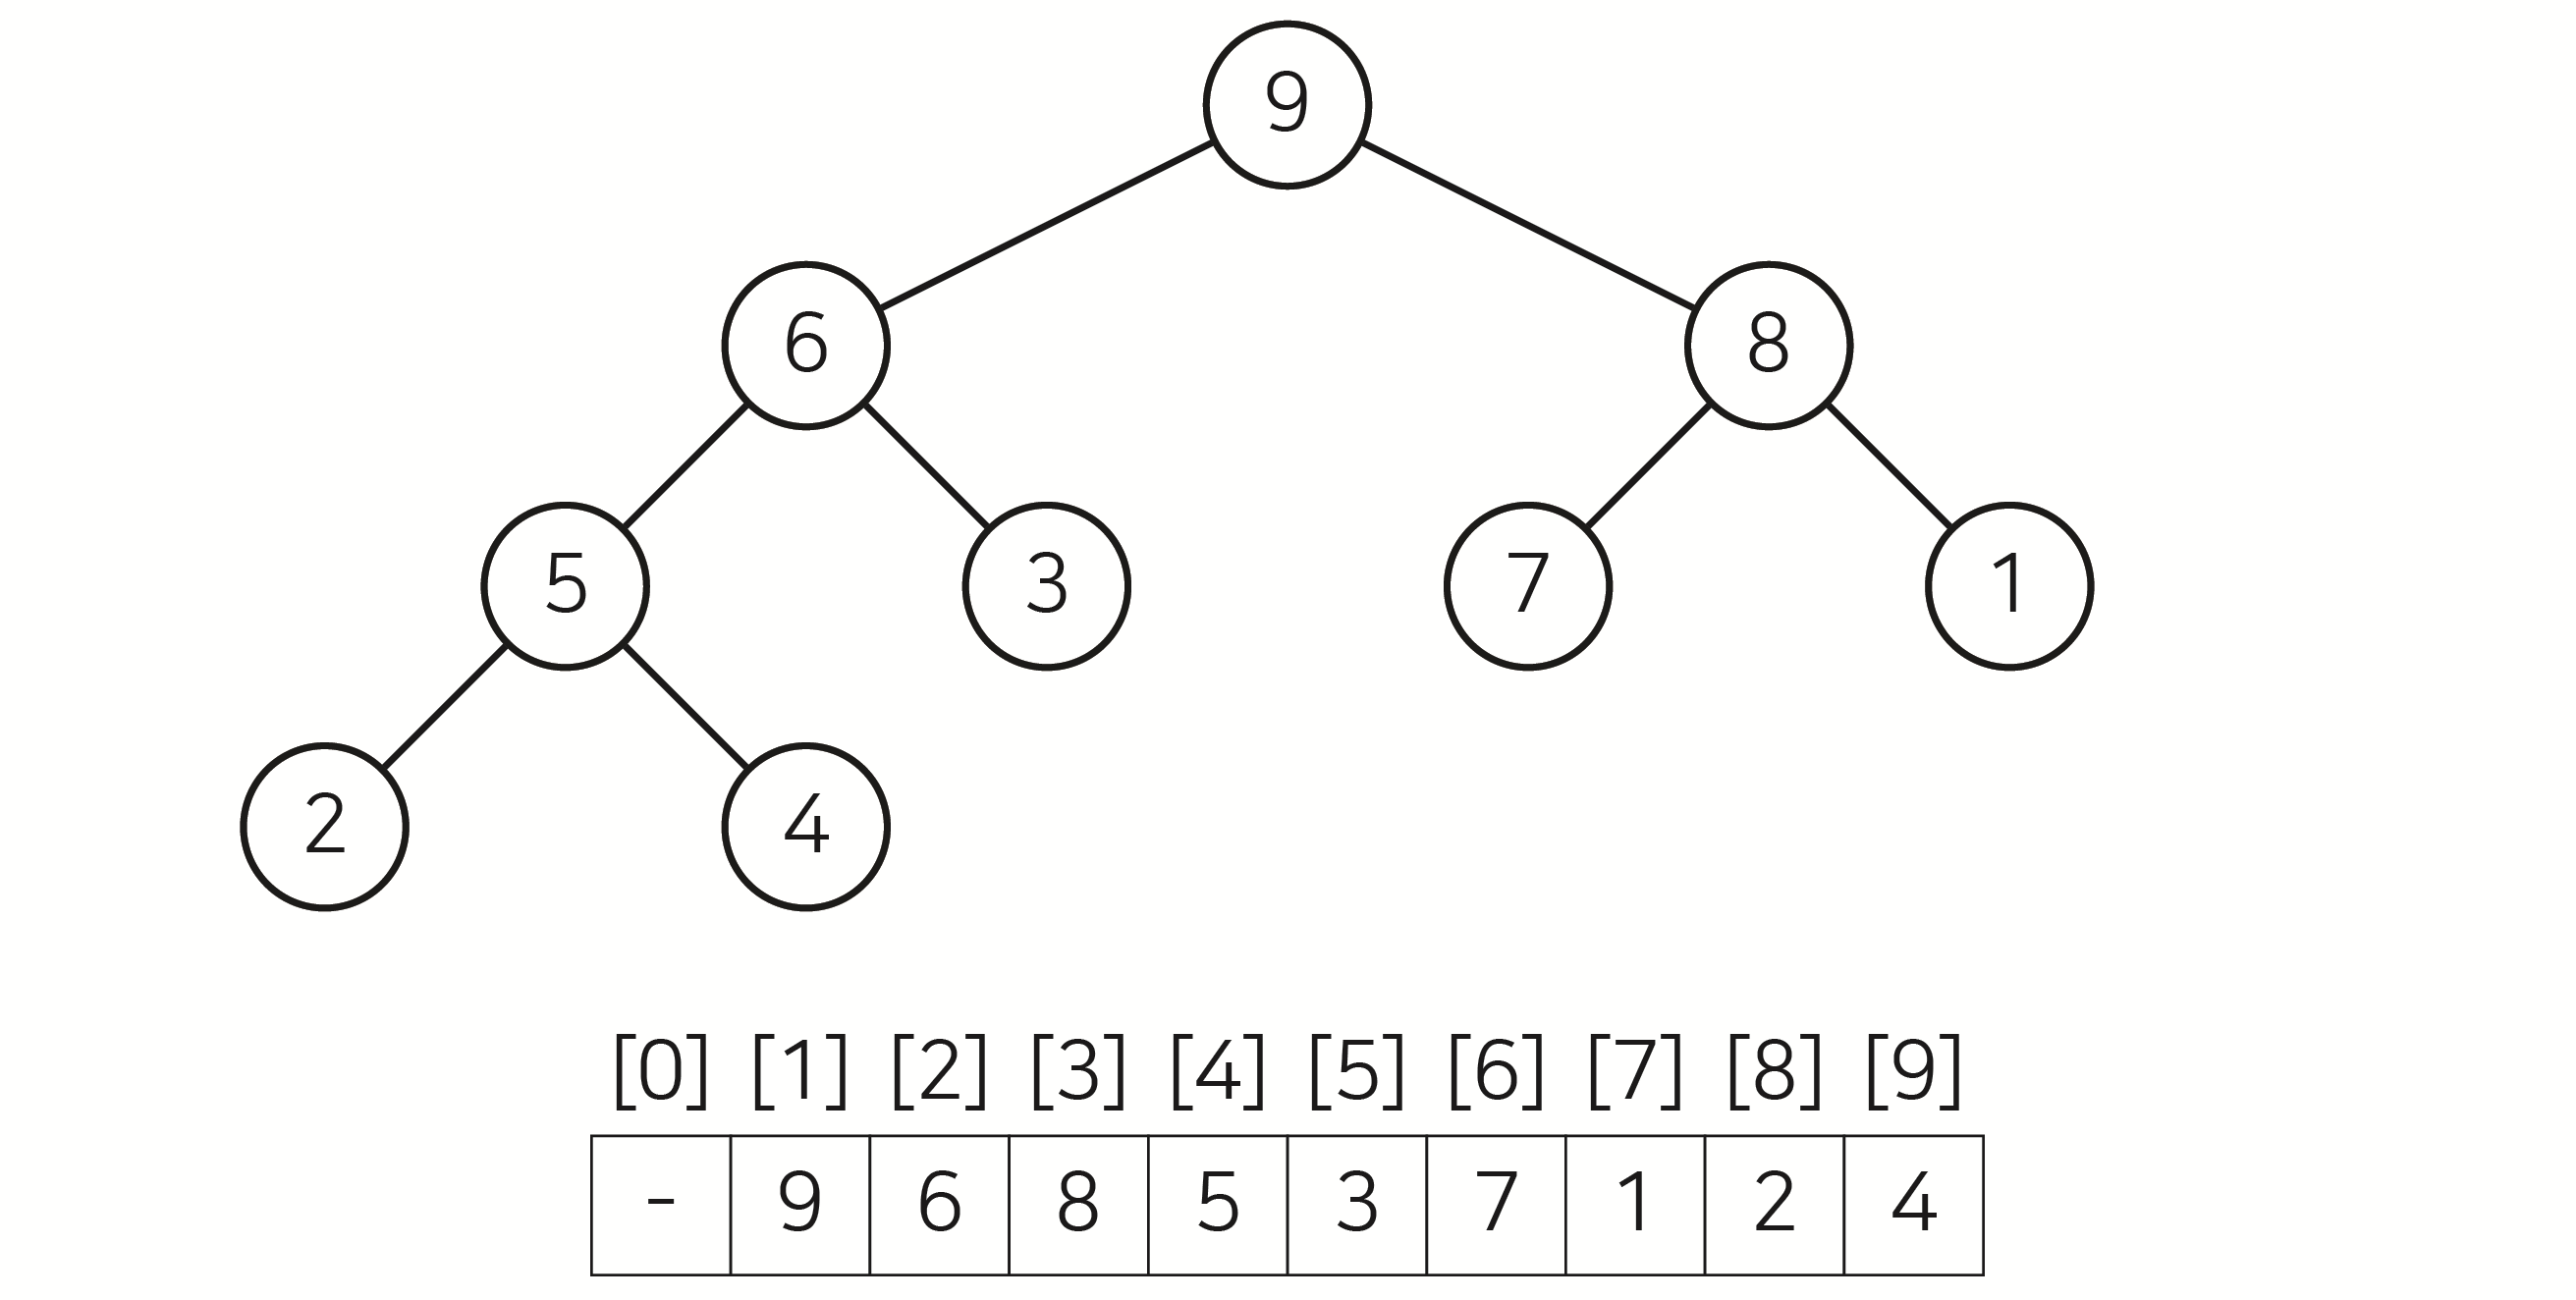
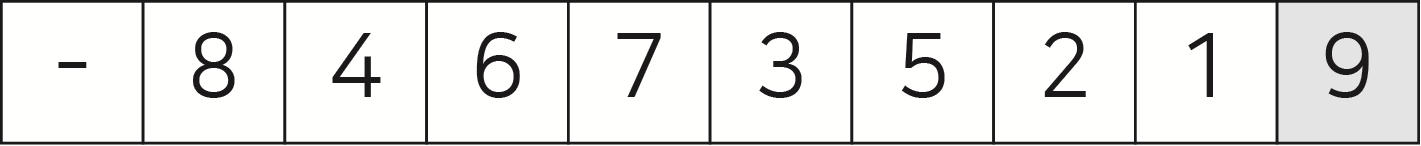
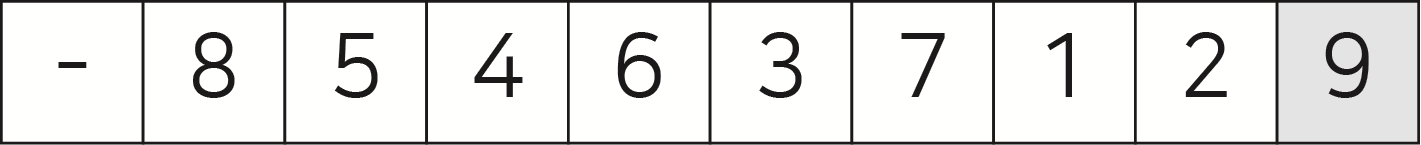
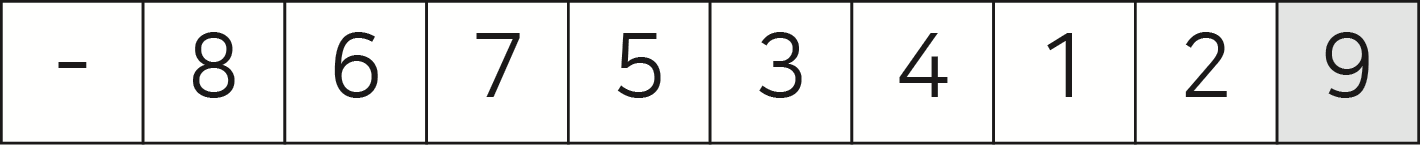
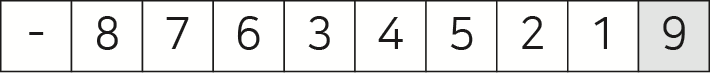
다음 그림과 같은 최대 힙(max heap)을 이용하여 힙 정렬을 수행할 때, 최댓값 9가 배열의 마지막 요소인 4와 교환된 다음, 힙 구조 유지를 위한 연산이 완료된 상태에서의 배열 내용으로 옳은 것은?
알고리즘
  1. ①
  2. ②
  3. ③
  4. ④
정답 보기

정답 ③ · 해설 보기

4.
다음은 초기상태 배열을 오름차순으로 정렬하는 단계들이다. 이와 같이 정렬을 수행하는 알고리즘으로 옳은 것은?
초기상태: [69, 10, 30, 3, 16, 8]
step 1: [3, 10, 30, 69, 16, 8]
step 2: [3, 8, 30, 69, 16, 10]
step 3: [3, 8, 10, 69, 16, 30]
step 4: [3, 8, 10, 16, 69, 30]
step 5: [3, 8, 10, 16, 30, 69]
알고리즘
  1. ①선택 정렬(selection sort)
  2. ②버블 정렬(bubble sort)
  3. ③합병 정렬(merge sort)
  4. ④기수 정렬(radix sort)
정답 보기

정답 ① · 해설 보기

5.
다음 중위 표기법 수식을 후위 표기법 수식으로 옳게 변환한 것은?
(A * B) - (C / D) - E
알고리즘
  1. ①A B * C D E - / -
  2. ②A B * C D / - E -
  3. ③A B * C D - / E -
  4. ④* A B - / C D - E
정답 보기

정답 ② · 해설 보기

6.
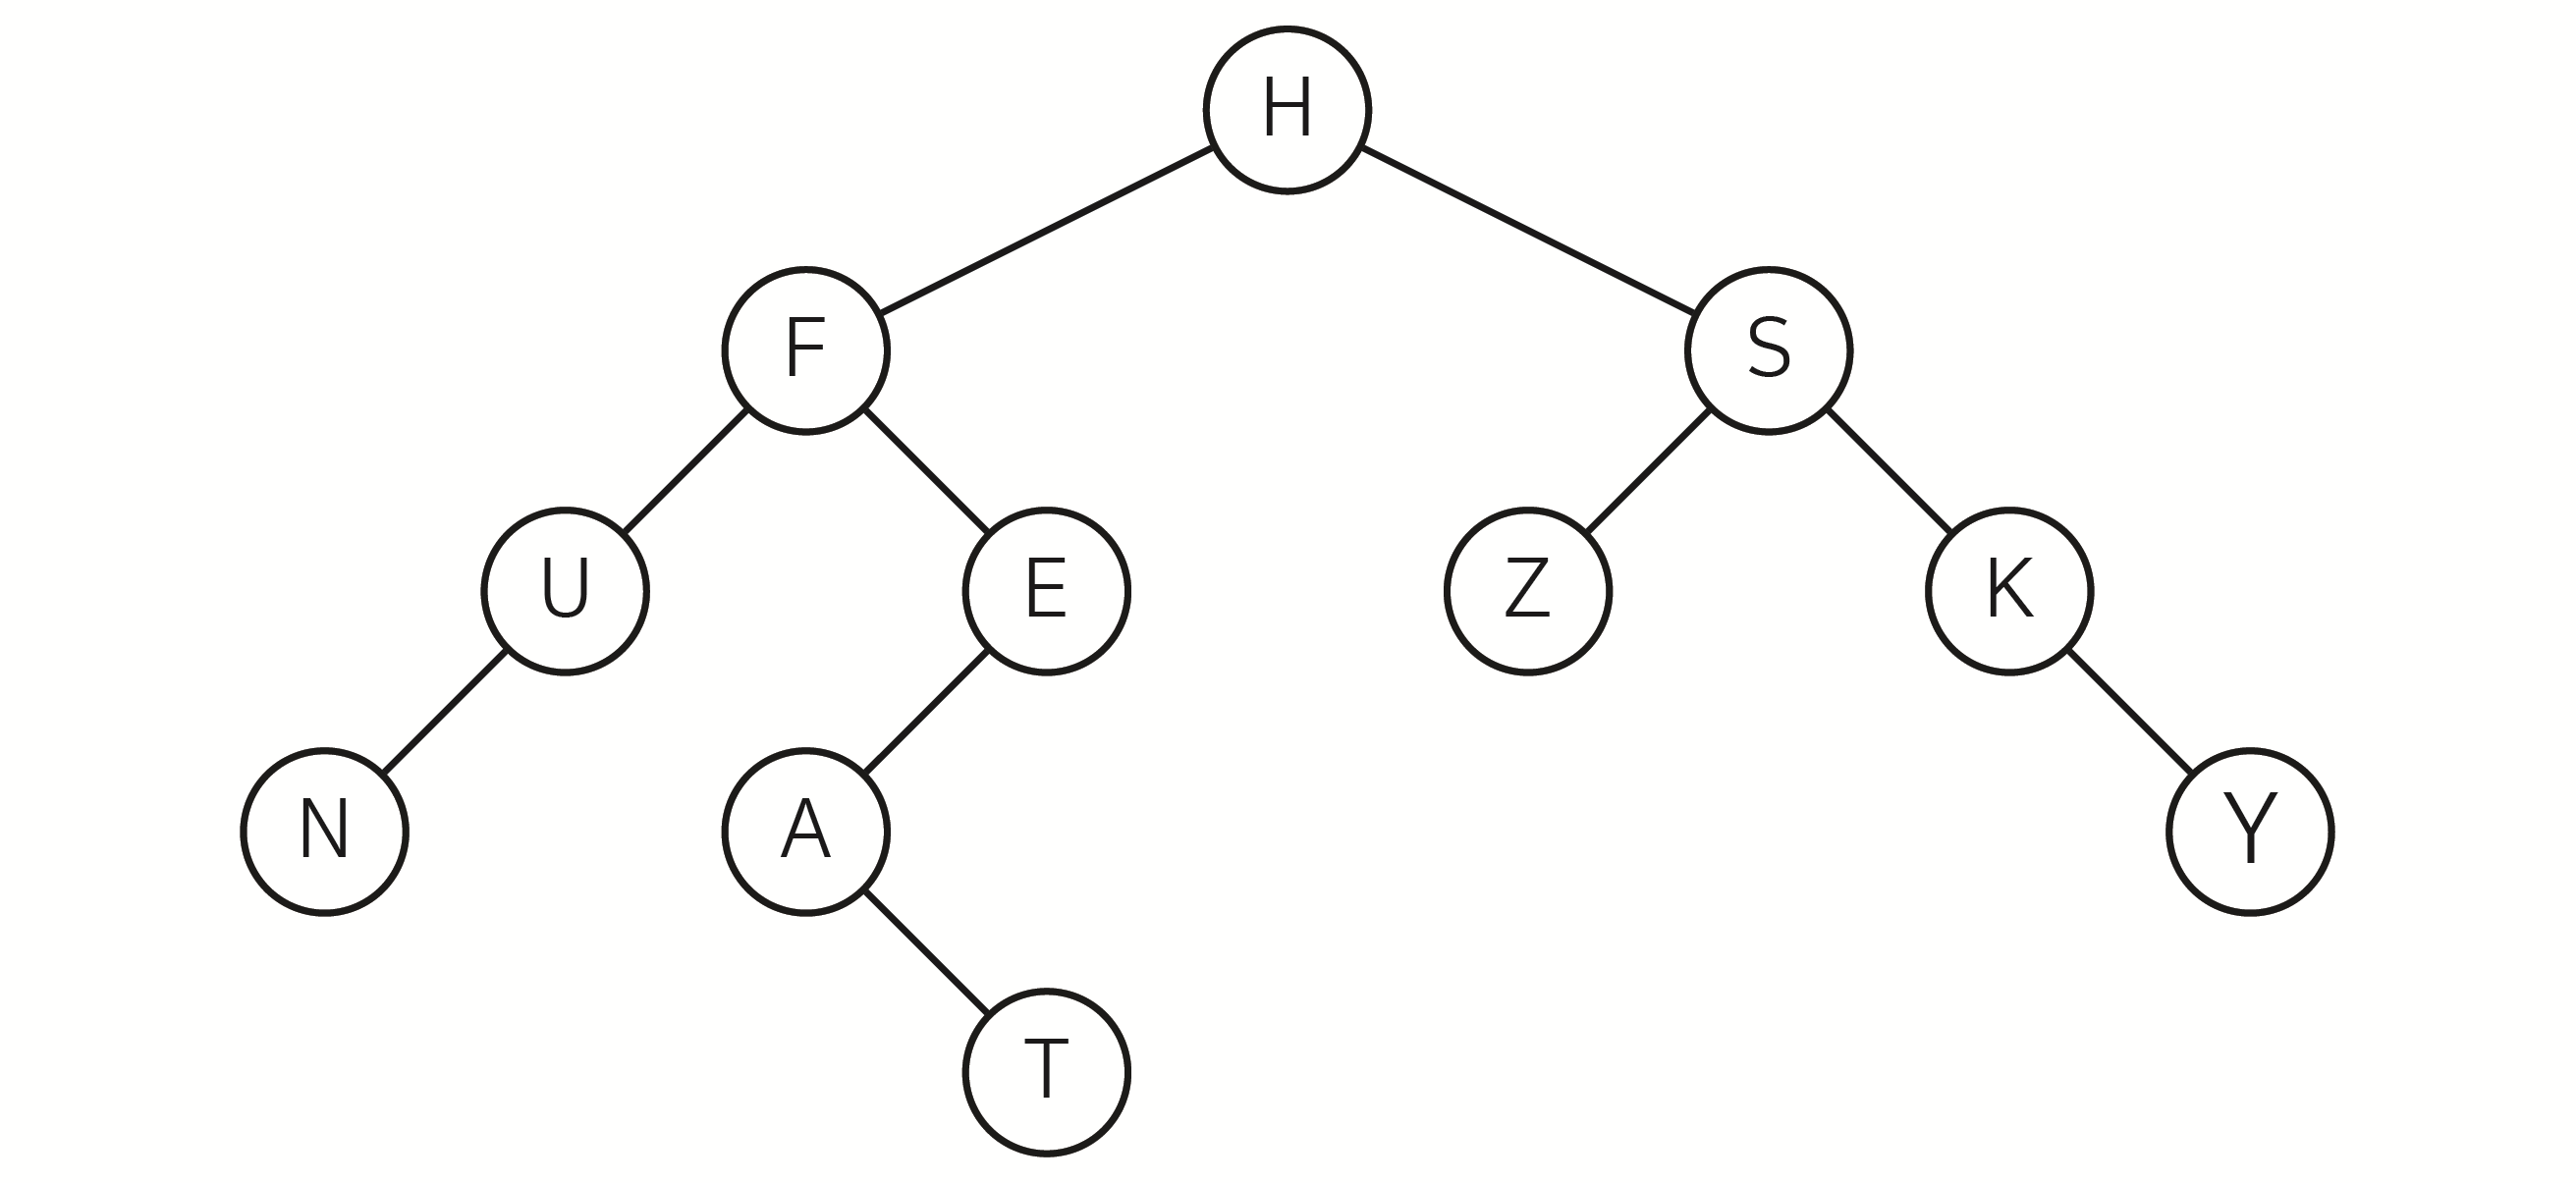
그림과 같이 연결되어 있는 11개의 여행지를 관광객들이 모두 방문할 수 있도록 안내하기 위해 C언어로 구현한 Course() 함수를 다음과 같이 제시하고 있다. 여행지 H를 파라미터로 하여 알고리즘을 호출했을 때, 출력결과의 (가) ~ (라)에 들어갈 내용을 바르게 연결한 것은? (단, 상위 노드 기준으로 n->left는 왼쪽으로 순회하고 n->right는 오른쪽으로 순회한다)
typedef struct node {
	char name;
	struct node *left;
	struct node *right;
} node;

void Course(node *n) {
	if(n != null) {
		Course(n->left);
		Course(n->right);
		printf("%c->", n->name);
	}
}
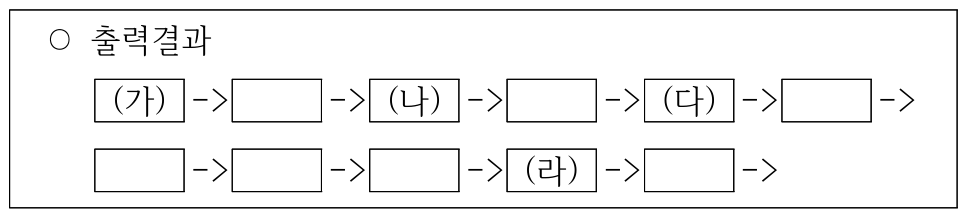
(가) (나) (다) (라)
알고리즘
  1. ①H A Z K
  2. ②H T S K
  3. ③N H U T
  4. ④N T E S
정답 보기

정답 ④ · 해설 보기

7.
다음 데이터를 순서대로 삽입하여 불균형이 발생했을 때 회전 연산을 수행하여 균형 상태를 유지하는 AVL 트리를 구성하였다. 구성된 AVL 트리에서 단말 노드(leaf node)에 해당하는 값만을 모두 고르면?
50, 60, 70, 90, 80, 75, 73, 72, 78
알고리즘
  1. ①72, 73, 90
  2. ②72, 75, 90
  3. ③50, 73, 75, 90
  4. ④50, 72, 78, 90
정답 보기

정답 ④ · 해설 보기

8.
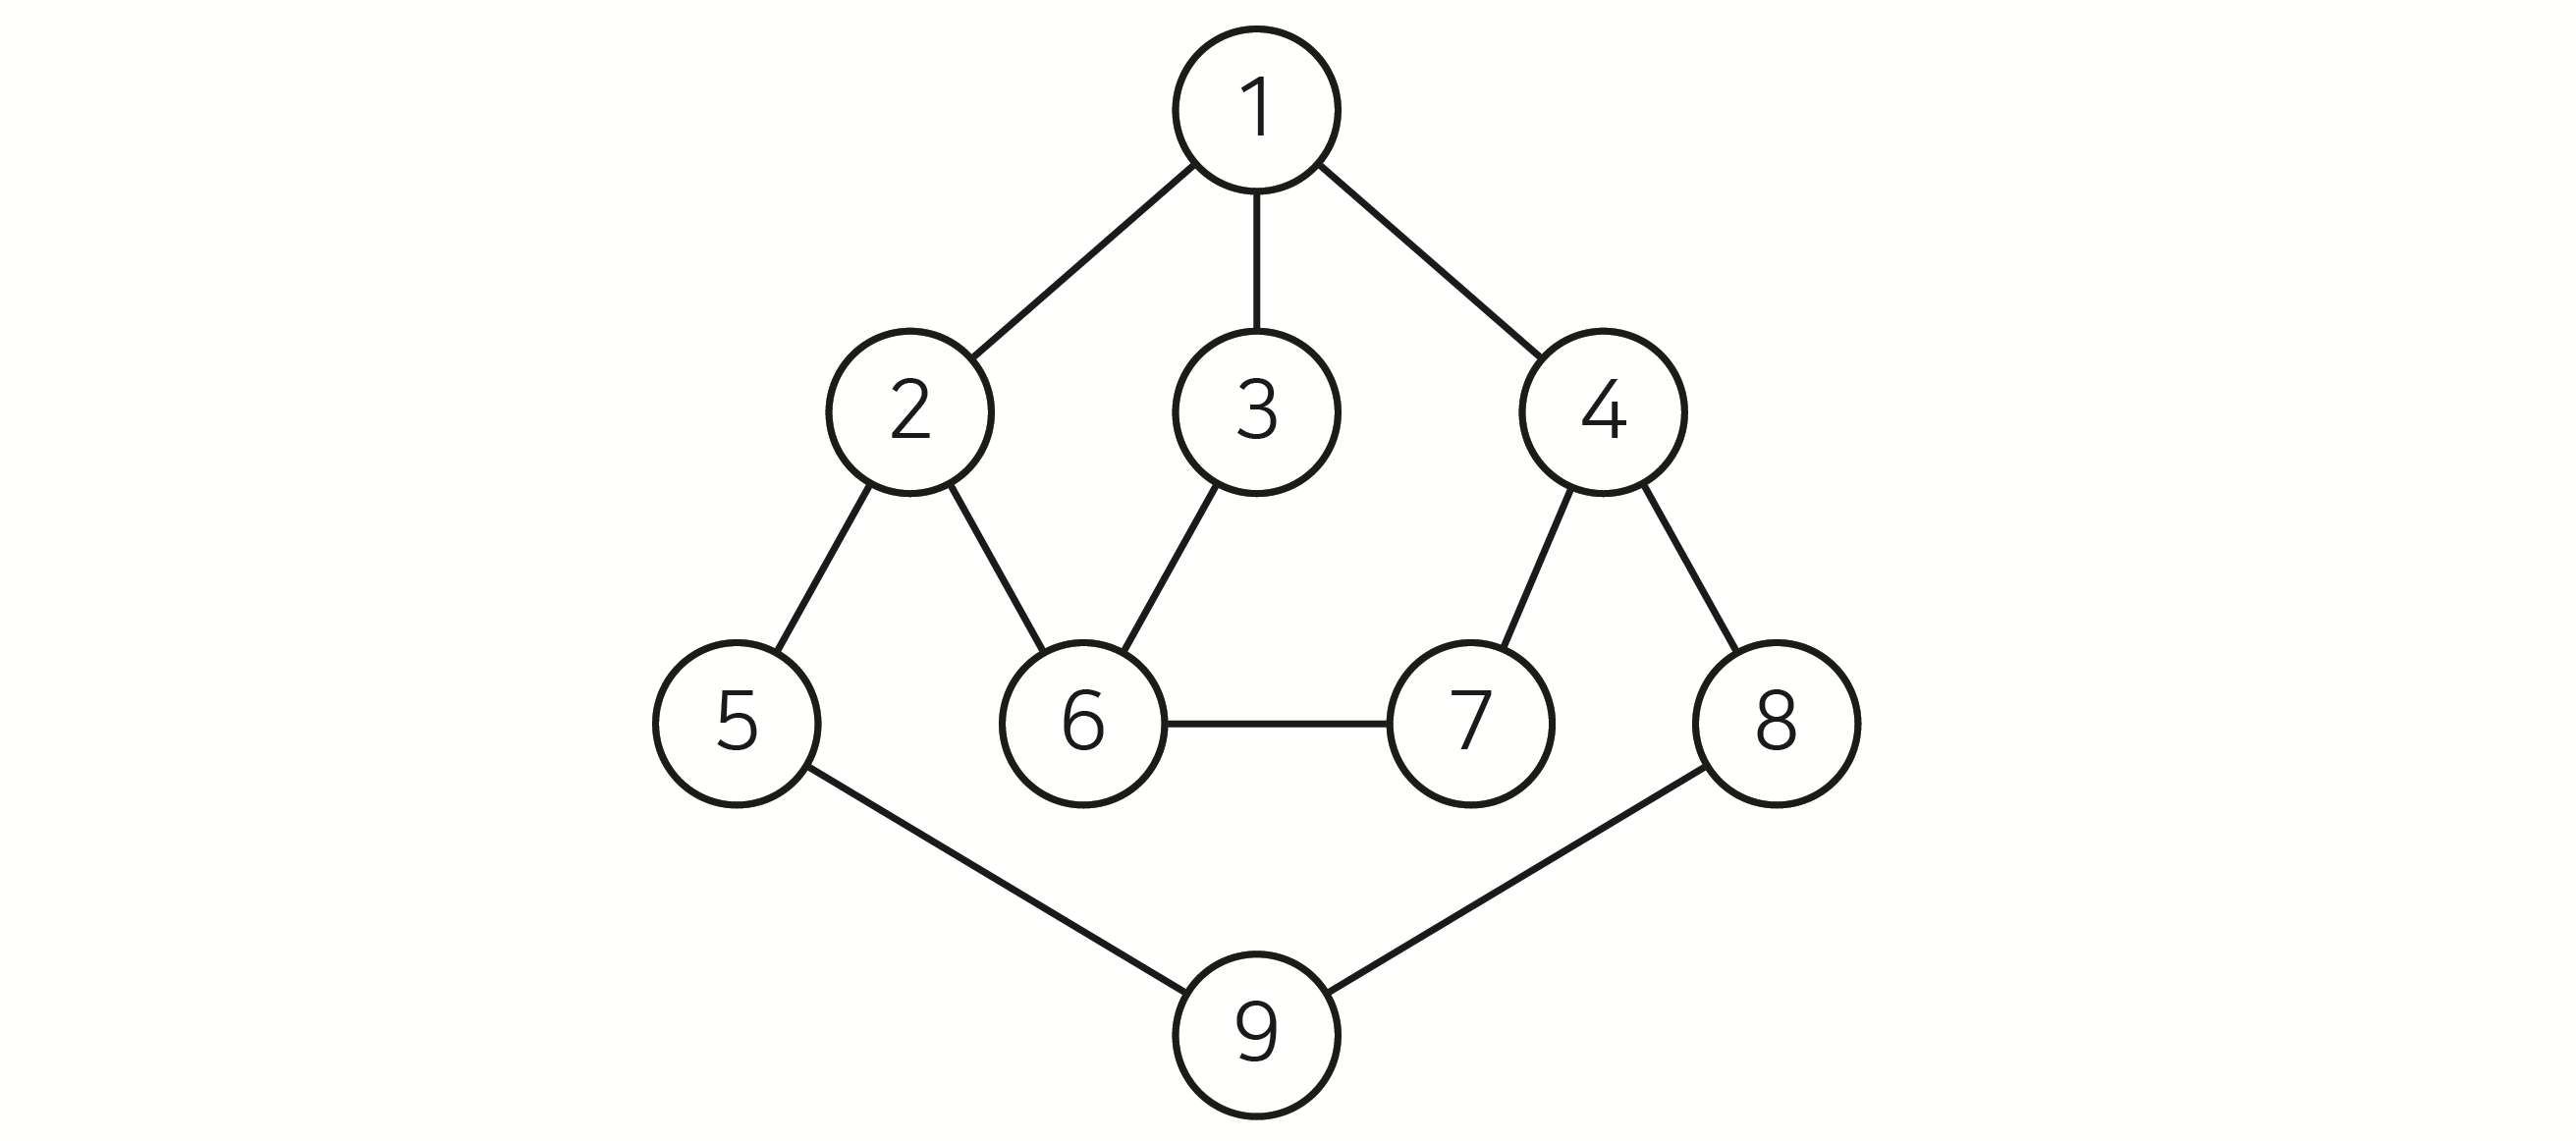
그림과 같은 그래프를 대상으로 다음 알고리즘을 적용하였을 때, 결과에 대한 설명으로 옳지 않은 것은? (단, 탐색의 시작 정점은 1이고, Q는 큐 객체이며, Q.enqueue()와 Q.dequeue()는 큐 Q에 대한 삽입과 삭제 연산이고, 각 정점의 방문을 표시하는 것은 visited[] 배열을 이용한다)
_FS(v) {
	visited[v] <- YES;	// 정점 v에 대한 방문 표시
	Q.enqueue(v)
	while(!Q.empty()) {	// Q가 비어있지 않은 동안
		w <- Q.dequeue();
		for all u ∈ (w에 인접한 정점) {
			if(visited[u] != YES) {
				visited[u] <- YES;
				Q.enqueue(u);
			}
		}
	}
}
알고리즘
  1. ①알고리즘의 수행에 따른 노드의 방문 순서는 1 → 2 → 5 → 9 → 8 → 4 → 7 → 6 → 3이다.
  2. ②너비 우선 탐색(BFS, Breadth First Search) 알고리즘이다.
  3. ③시작 정점으로부터 가까운 정점들을 먼저 방문하고 멀리 떨어져 있는 정점들을 나중에 방문하는 탐색방법이다.
  4. ④알고리즘은 그래프의 모든 정점을 방문한다.
정답 보기

정답 ① · 해설 보기

9.
다음 C언어 함수 ABC()에 대한 설명으로 옳은 것은?
void ABC(int A[], int n) {
	int i, j, tmp;
	for(i = n - 1; i > 0; i--) {
		j = 0;
		while(j < i) {
			if(A[j] < A[j + 1]) {
				tmp = A[j];
				A[j] = A[j + 1];
				A[j + 1] = tmp;
			}
			j = j + 1;
		}
	}
}
알고리즘
  1. ①코드 수행 완료 후, A[0]에는 가장 큰 원소가 저장되어 있다.
  2. ②코드 수행 완료 후, 배열 A의 원소는 오름차순으로 정렬되어 있다.
  3. ③최선의 경우와 최악의 경우의 수행 시간 복잡도가 다르다.
  4. ④코드는 삽입 정렬(insertion sort)을 구현한 것이다.
정답 보기

정답 ① · 해설 보기

10.
다음 자료를 차수가 3인 B-트리에 순서대로 삽입하여 그림과 같은 B-트리를 생성하였을 때, (가) ~ (다)에 들어갈 값을 바르게 연결한 것은?
75, 15, 10, 12, 5, 30, 1, 2, 25, 27, 34, 60
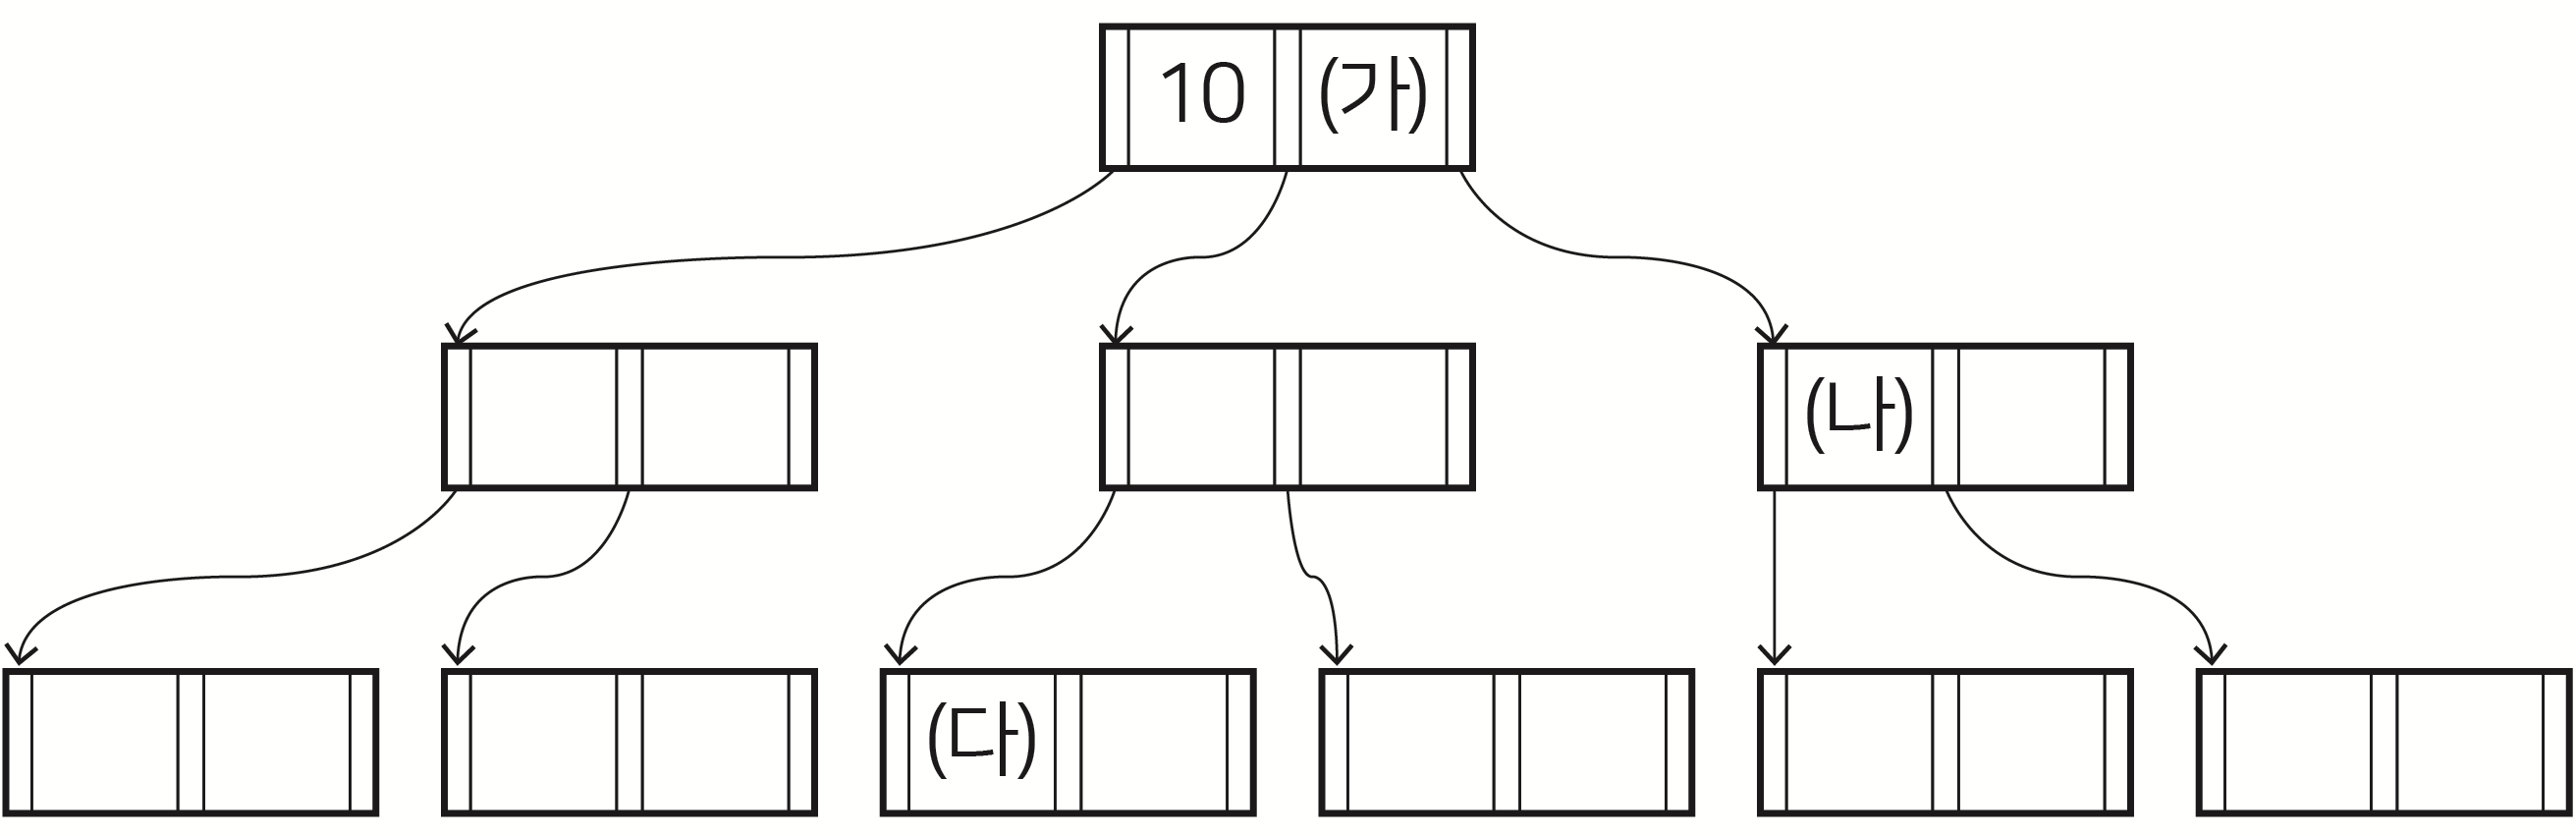
(가) (나) (다)
알고리즘
  1. ①25 34 12
  2. ②25 60 15
  3. ③30 34 15
  4. ④30 60 12
정답 보기

정답 ④ · 해설 보기

11.
다음은 재귀 호출을 이용하여 피보나치(Fibonacci) 수열값을 찾는 파이썬 코드이다. 이 코드의 시간 복잡도는? (단, n은 0 이상의 정수이다)
def fib(n):
	if n == 0:
		return 0
	elif n == 1:
		return 1
	else:
		return fib(n – 1) + fib(n – 2)
알고리즘
  1. ①
  2. ②
  3. ③
  4. ④
정답 보기

정답 ③ · 해설 보기

12.
분할 정복(divide-and-conquer) 방식의 정렬 알고리즘에 대한 설명으로 옳지 않은 것은?
알고리즘
  1. ①2-way 합병 정렬의 분할은 분할 대상을 반으로 나눈다.
  2. ②퀵정렬(quick sort)의 분할은 분할 대상에 대하여 피봇(pivot)을 기준으로 나눈다.
  3. ③합병 정렬과 다르게 퀵정렬에서는 모든 분할이 완료되면 정렬도 완료된다.
  4. ④합병 정렬은 추가 데이터 저장공간이 필요 없는 제자리 정렬 알고리즘이다.
정답 보기

정답 ④ · 해설 보기

13.
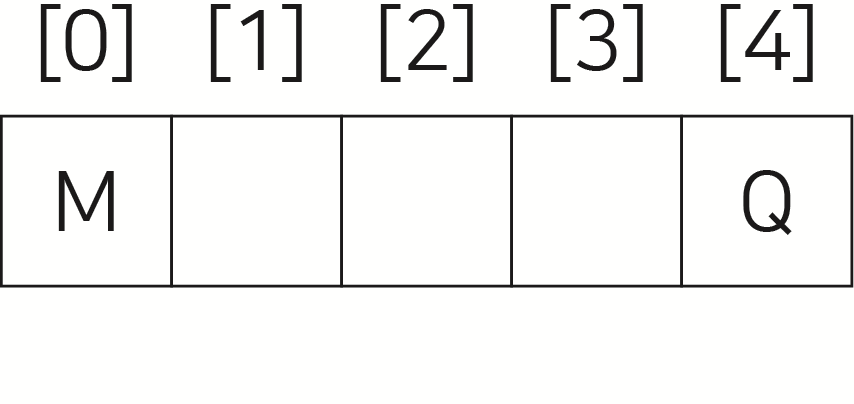
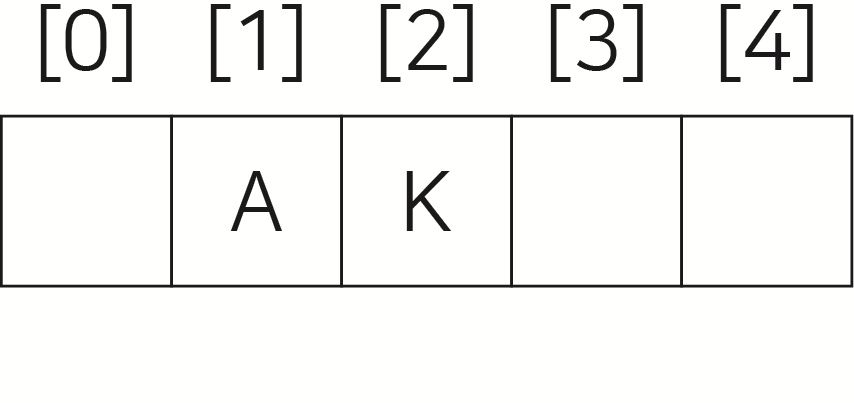
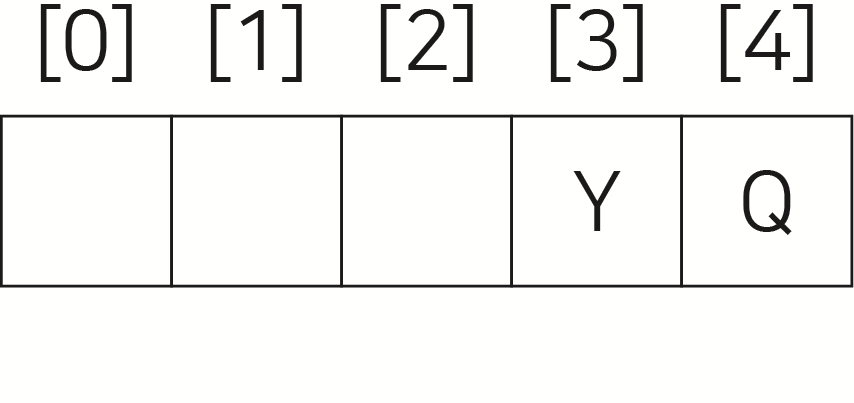
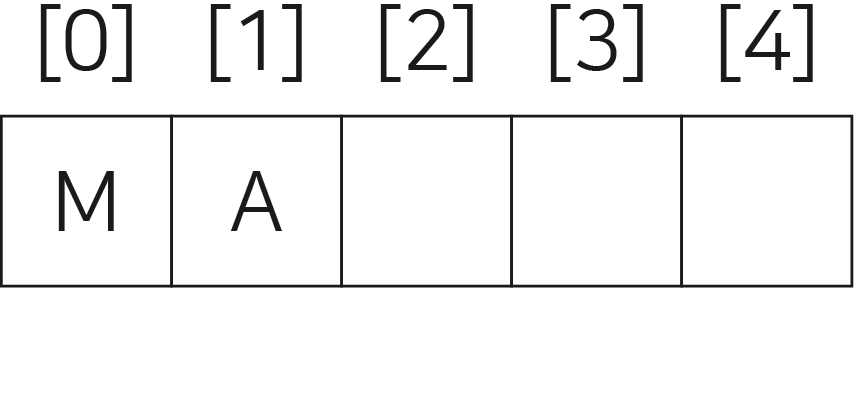
배열로 운영하는 원형 큐에 대해 다음과 같이 연산 1에서 7까지의 연산을 차례로 수행했을 때, 수행이 완료된 후 큐의 상태로 옳은 것은? (단, 현재 상태에서 front = 0, rear = 2이다)
연산 1. 원소 Y 삽입
연산 2. 원소 3개 삭제
연산 3. 원소 Q 삽입
연산 4. 원소 M 삽입
연산 5. 원소 A 삽입
연산 6. 원소 K 삽입
연산 7. 원소 2개 삭제
알고리즘
  1. ①
  2. ②
  3. ③
  4. ④
정답 보기

정답 ② · 해설 보기

14.
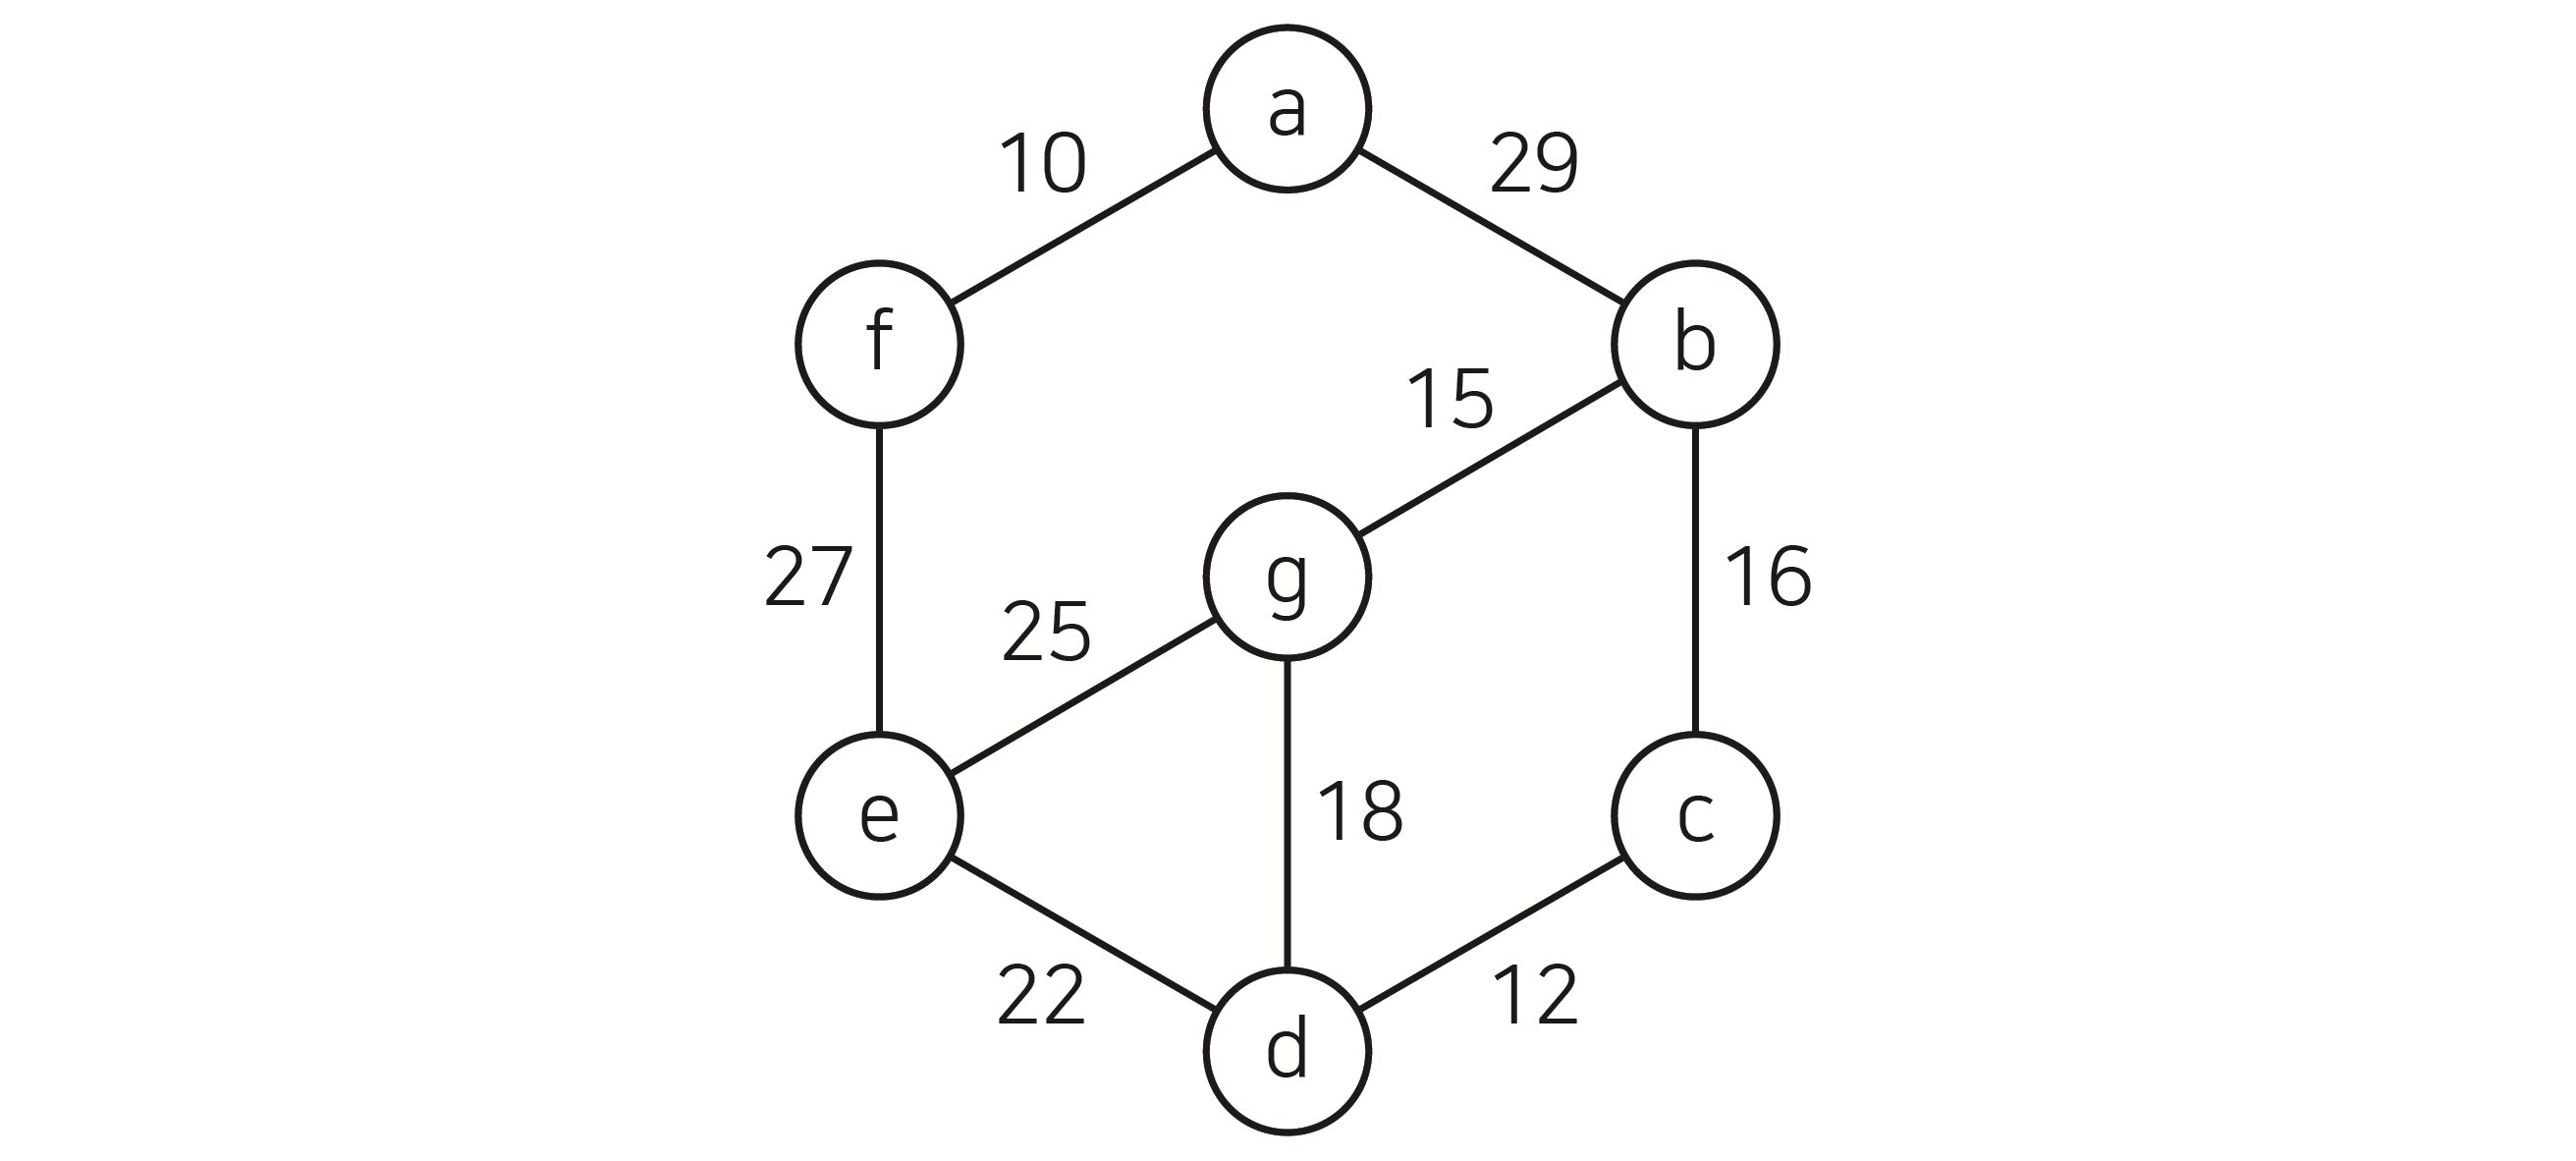
다음 그래프를 대상으로 크루스칼(Kruskal) 알고리즘을 적용하여 최소 신장 트리(MST, Minimum Spanning Tree)를 구성하고자 할 때, 생성되는 MST에 5번째 추가되는 간선과 비용을 바르게 연결한 것은?
간선 비용
알고리즘
  1. ①(b, c) 16
  2. ②(d, g) 18
  3. ③(d, e) 22
  4. ④(e, g) 25
정답 보기

정답 ③ · 해설 보기

15.
문자열 매칭을 위한 알고리즘으로 옳은 것은?
알고리즘
  1. ①합병 정렬 알고리즘
  2. ②라빈 카프(Rabin-Karp) 알고리즘
  3. ③백트래킹(backtracking) 알고리즘
  4. ④후위 순회(postorder traversal) 알고리즘
정답 보기

정답 ② · 해설 보기

16.
다음은 단일 출발점 최단 경로를 찾기 위한 다익스트라(Dijkstra) 알고리즘을 의사(pseudo) 코드로 기술한 것이다. 이 코드에서 (가)에 들어갈 내용으로 옳은 것은?
// 입력: 가중 방향 그래프 G, 인접 행렬 A, 시작 정점 s
// 출력: s로부터 다른 모든 정점까지의 최단 경로의 길이 
Dijkstra(G, A, s) {
	U = {s};
	for(모든 정점 v ∈ G)
		D[v] = A[s][v];
	while(U != G) {
		D[w]가 최소인 정점 w ∈ (G–U)를 선택
		U = U ∪ {w};
		for(w에 인접한 모든 정점 v) {
			D[v] = (가);
		}
	}
}
알고리즘
  1. ①min(D[v], D[v] + A[v][w])
  2. ②min(D[v], D[w] + A[v][w])
  3. ③min(D[v], D[v] + A[w][v])
  4. ④min(D[v], D[w] + A[w][v])
정답 보기

정답 ④ · 해설 보기

17.
KMP(Knuth-Morris-Pratt) 알고리즘과 보이어-무어(Boyer-Moore) 알고리즘에 대한 설명으로 옳지 않은 것은?
알고리즘
  1. ①KMP 알고리즘은 패턴 문자열의 첫 문자부터 순차적으로 대상 문자열과 부분 문자열의 일치 여부를 판단한다.
  2. ②KMP 알고리즘은 패턴 문자열과 대상 문자열을 한 차례 비교한 후 얻을 수 있는 추가 정보로 비교 횟수를 감소시킨다.
  3. ③보이어-무어 알고리즘은 패턴 문자열의 마지막 문자부터 역순으로 대상 문자열과 부분 문자열의 일치 여부를 판단한다.
  4. ④보이어-무어 알고리즘은 전처리(preprocessing) 과정 없이 곧바로 일치 여부를 판단할 수 있다.
정답 보기

정답 ④ · 해설 보기

18.
다음 조건에 따라 주어진 그래프에 대해 깊이 우선 탐색(DFS, Depth First Search) 방법을 이용하여 트리를 만들 경우, 나올 수 있는 트리의 개수와 수행하는 백트래킹 횟수를 바르게 연결한 것은?
○ DFS의 시작 정점은 A로 하고, 정점의 접근 순서는 알파벳 순서로 한다.
○ DFS는 사이클을 형성하지 않으면서 백트래킹을 통해 시작 정점으로 돌아왔을 때, 시작 정점에서 방문하지 않은 접근 가능한 인접 정점이 없으면 종료한다.
○ DFS의 종료시점에 그래프에 방문하지 않은 정점들이 존재하면, 방문하지 않은 정점들 중 알파벳 순서가 가장 앞선 정점을 시작 정점으로 하여 DFS를 다시 시작한다.
○ 그래프 안에 방문하지 않은 정점이 존재하지 않을 때까지 DFS를 반복한다.
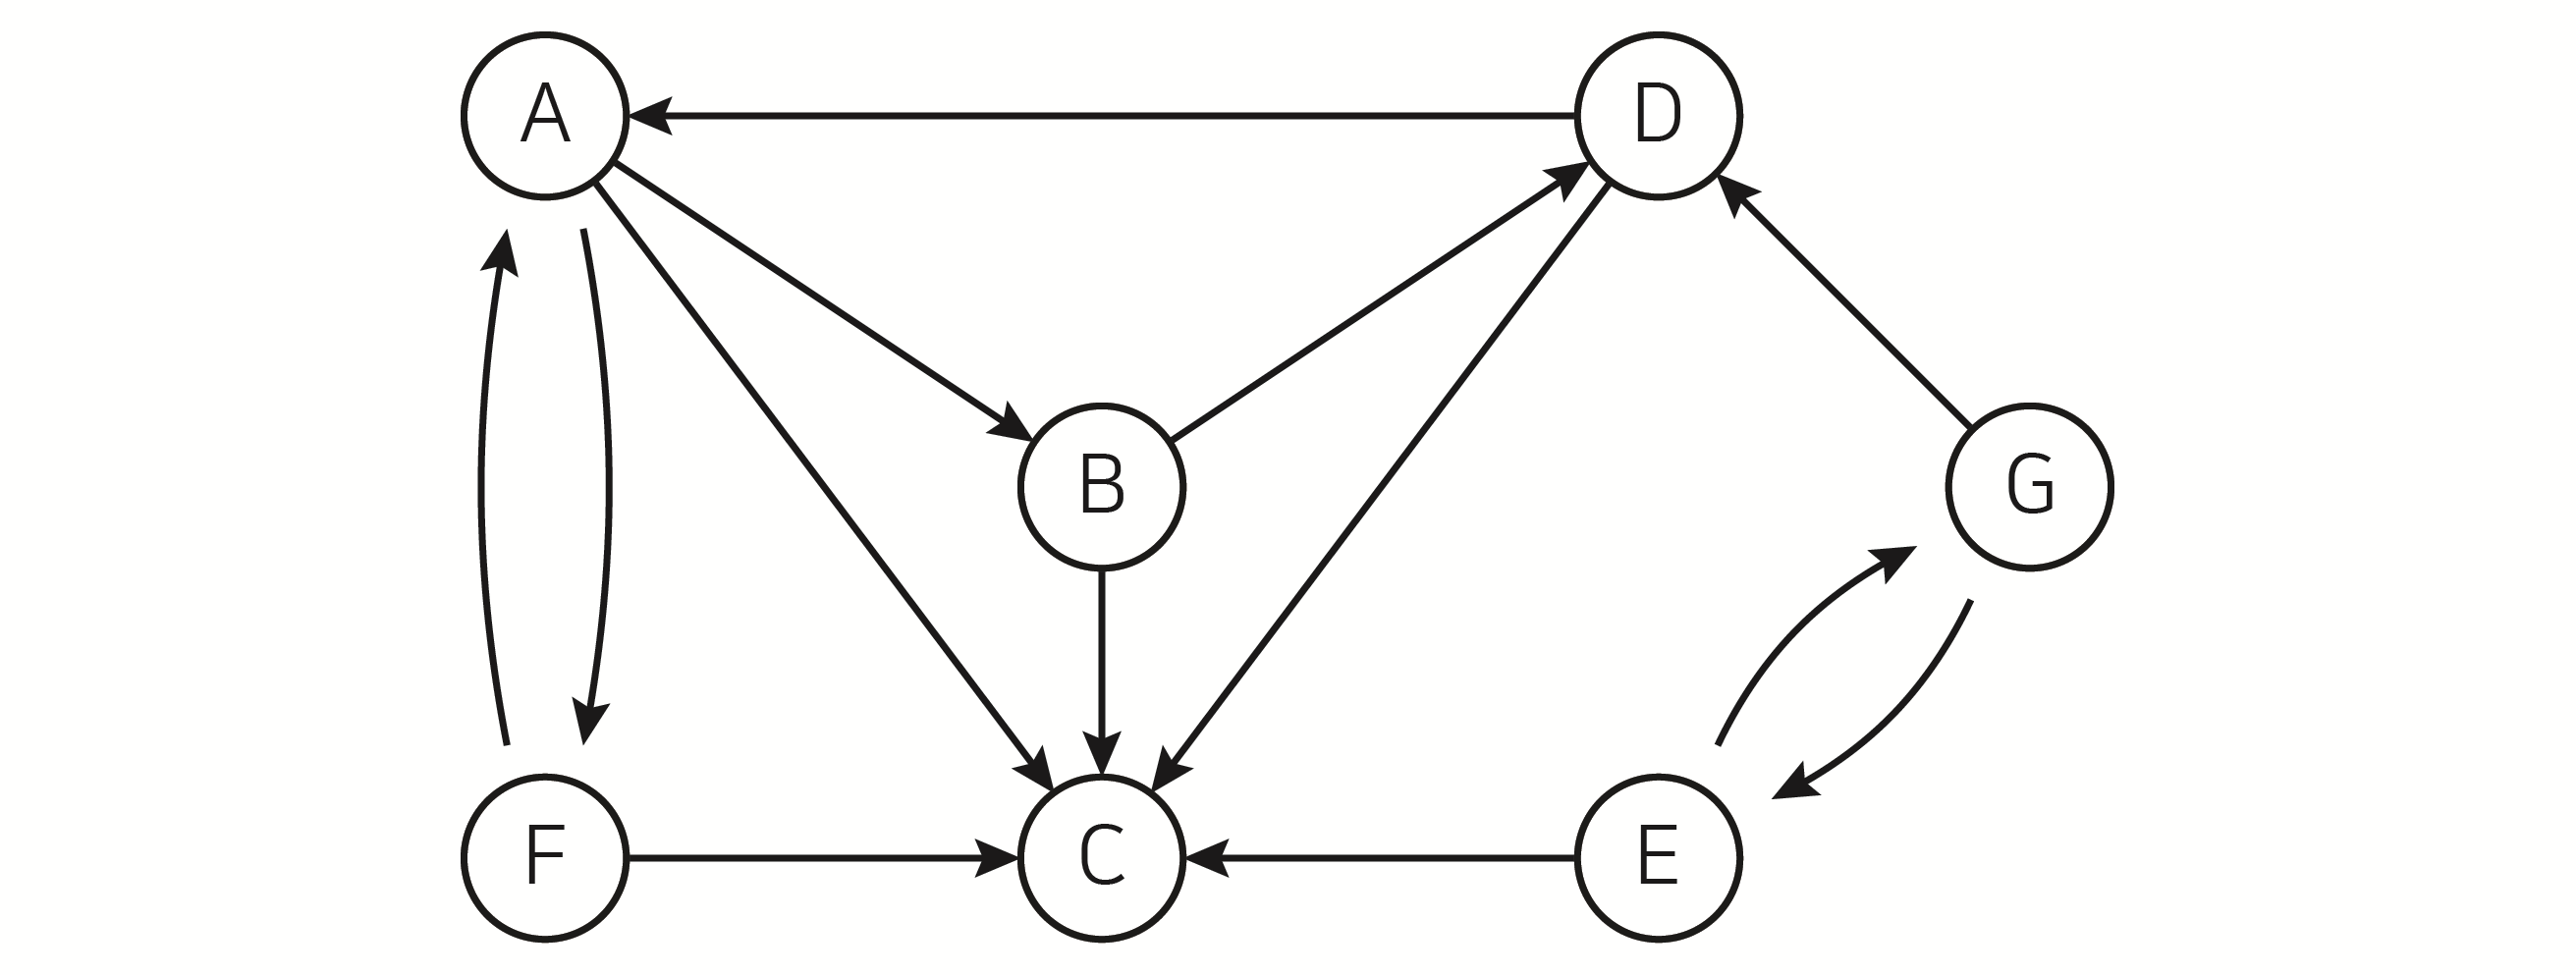
트리의 개수 백트래킹 횟수
알고리즘
  1. ①1 3
  2. ②1 4
  3. ③2 3
  4. ④2 5
정답 보기

정답 ④ · 해설 보기

19.
다음은 n개의 데이터에 대한 평균을 재귀적으로 계산하는 프로그램이다. (가) ~ (다)에 들어갈 내용을 바르게 연결한 것은? (단, n ≥ 1이다)
float AVG(float (가), int n) {
	if(n == 1) return (나);
		else
			return (data[n - 1] + (n - 1) * AVG(data, n - 1)) / (다);
}
(가) (나) (다)
알고리즘
  1. ①data[] 0 n
  2. ②data[] 1 (n - 1)
  3. ③*data data[0] n
  4. ④*data data[n - 1] (n - 1)
정답 보기

정답 ③ · 해설 보기

20.
작업 선택 문제를 다루는 다음 알고리즘은 각 작업의 시작 시간 s와 완료 시간 f가 정해진 개의 작업 t[0..n-1]가 주어질 때, 하나의 기계만 사용하여 충돌 없이 수행할 수 있는 최대 개수의 작업을 선택한다. 이 알고리즘의 (가), (나)에 들어갈 내용을 바르게 연결한 것은? (단, n ≥ 2인 정수, count는 선택한 작업의 개수, t[i].s는 작업 t[i]의 시작 시간, t[i].f는 작업 t[i]의 종료 시간이고, jobs 배열은 선택된 작업을 저장한다)
ActSelect(n, t[]) {
	(가)의 오름차순으로 작업 t[]를 정렬;
	count = 0, last = 0, jobs[];
	jobs[count] = 0;
	for(i = 0; i < n; i++)
		if((나)) {
			count++;
			last = i;
			jobs[count] = last;
		}
	return jobs;
}
(가) (나)
알고리즘
  1. ①시작 시간 t[i].s >= t[last].f
  2. ②시작 시간 t[i].f >= t[last].s
  3. ③완료 시간 t[i].s >= t[last].f
  4. ④완료 시간 t[i].f >= t[last].s
정답 보기

정답 ③ · 해설 보기

21.
동적 프로그래밍(dynamic programming) 방법으로 최소의 원소단위 곱셈 횟수를 갖도록 연쇄 행렬곱셈(matrix-chain multiplication)의 순서를 정하려 한다. 를 행렬 부터 까지의 연쇄 행렬곱셈의 최소 비용이라고 할 때, 에 대한 관계식으로 옳은 것은? (단, 이고, 각 행렬의 차원이 일 때, 행렬 의 크기는 이다)
알고리즘
  1. ①
  2. ②
  3. ③
  4. ④
정답 보기

정답 ① · 해설 보기

22.
동적 프로그래밍은 한 번 계산된 값을 메모리에 저장한 후, 저장된 값을 필요할 때마다 가져다 쓰는 방법이다. 동적 프로그래밍을 적용하여 구현한 다음 Java 프로그램에서 피보나치 수열 fibo(6)을 구하기 위해 저장되어 있는 fibo(3)의 결과를 가져다 쓰는 횟수는?
public class Fibonacci {
	static int[] dp = new int[100];

	public static void main(String[] args) {
		System.out.println(fibo(6));
	}

	public static int fibo(int num) {
		if(num == 0) {
			return 0;
		}
		if(num == 1) {
			return 1;
		}
		if(dp[num] != 0) {
			return dp[num];
		}
		return dp[num] = fibo(num - 1) + fibo(num - 2);
	}
}
알고리즘
  1. ①0
  2. ②1
  3. ③2
  4. ④3
정답 보기

정답 ② · 해설 보기

23.
배낭 문제(knapsack problem)에 대한 설명으로 옳은 것은?
알고리즘
  1. ①0-1 배낭 문제와 분할 가능 배낭 문제는 다항식 시간(polynomial-time) 문제이다.
  2. ②분할 가능 배낭 문제는 최적 부분 구조를 갖지만, 0-1 배낭 문제는 그렇지 않다.
  3. ③0-1 배낭 문제는 물건을 나눌 수 없어서 그리디(greedy) 알고리즘을 적용하여 해결할 수 있으며, 분할 가능 배낭 문제는 물건을 나눌 수 있어 동적 프로그래밍으로 해결해야 한다.
  4. ④분할 가능 배낭 문제는 ‘단위 무게당 가치가 가장 높은 물건을 선택’하는 방식이 항상 최적해를 보장하지만, 0-1 배낭 문제는 그렇지 않다.
정답 보기

정답 ④ · 해설 보기

24.
알고리즘들에 대한 설명으로 옳지 않은 것은?
알고리즘
  1. ①크루스칼의 최소 신장 트리 알고리즘은 가중치가 가장 작으면서 사이클을 만들지 않는 간선을 추가하여 트리를 구성한다.
  2. ②프림(Prim)의 최소 신장 트리 알고리즘은 현재까지 만들어진 트리에 최소 가중치로 연결되는 정점을 트리에 추가한다.
  3. ③허프만(Huffman) 압축에서 파일에 빈번히 나타나는 문자는 긴 이진코드를 할당하고, 드물게 나타나는 문자는 짧은 이진코드를 할당한다.
  4. ④벨만-포드(Bellman-Ford)의 최단 경로 알고리즘은 음의 가중치를 갖는 간선이 존재하는 상황에서도 단일 출발점 최단 경로 문제를 해결하는 알고리즘이다.
정답 보기

정답 ③ · 해설 보기

25.
다음 설명에 해당하는 알고리즘은?
○ 주어진 문제에 대해 근사해나 일정 확률 이상의 최적해를 출력함
○ 근사해나 간혹 틀린 해를 허용할 수 있는 경우에 사용 가능함
○ 효율적인 결정론적 알고리즘이 밝혀져 있지 않은 문제에 효과적임
알고리즘
  1. ①유클리드(Euclid) 알고리즘
  2. ②스트라센(Strassen) 알고리즘
  3. ③몬테카를로(Monte Carlo) 알고리즘
  4. ④플로이드-워샬(Floyd-Warshall) 알고리즘
정답 보기

정답 ③ · 해설 보기