7급 국가직 자료구조론 2010년 기출문제

시행 2010-07-24 · 책형 고 · 20문항 · 출처: 인사혁신처 공개 기출(공공데이터포털, 이용허락 제한 없음)

전체 풀기 (시험 모드)원본 PDF 받기2010 7급 국가직 전과목
1.
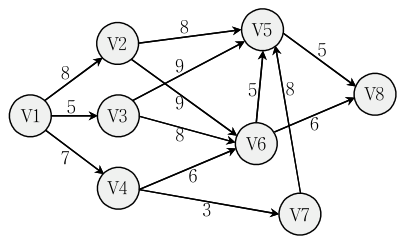
다음 AOE(activity on edge) 네트워크로 표현된 작업들은 병렬로 수행된다. 이 그래프에서 나타나는 임계 경로(critical path)는?
자료구조론
  1. ①V1 - V3 - V6 - V5 - V8
  2. ②V1 - V4 - V6 - V5 - V8
  3. ③V1 - V2 - V6 - V5 - V8
  4. ④V1 - V4 - V7 - V5 - V8
정답 보기

정답 ③ · 해설 보기

2.
아래 코드는 가용공간 리스트로부터 노드를 할당 받아 이중연결리스트에 새로운 값 x를 삽입하기 위한 함수의 일부이다. 할당 받은 노드에 대한 포인터는 new이고, 이중연결리스트에서의 삽입 위치는 pre가 가리키는 노드 뒤라고 하자. 밑줄 친 ㉠, ㉡에 알맞은 문장은?
new ← getNode();
new.data ← x;
㉠
㉡
pre.rlink ← new;
new.llink ← pre;
㉠ ㉡
자료구조론
  1. ①new.rlink ← pre.rlink; new.rlink.llink ← new.llink;
  2. ②new.llink ← pre.rlink; new.llink.rlink ← new;
  3. ③new.llink ← pre.rlink; new.llink.rlink ← new.rlink;
  4. ④new.rlink ← pre.rlink; new.rlink.llink ← new;
정답 보기

정답 ④ · 해설 보기

3.
다음과 같은 키 값을 갖는 데이터들을 순서대로 삽입하여 AVL 트리를 구성했을 때, 이 트리에서 각 키를 탐색하기 위한 평균 비교횟수는?
8, 12, 23, 9, 7, 6
자료구조론
  1. ①
  2. ②
  3. ③
  4. ④
정답 보기

정답 ① · 해설 보기

4.
아래의 알고리즘은 주어진 단순연결리스트를 역순으로 변환하는 알고리즘이다. 알고리즘의 ㉠에 들어갈 내용으로 옳은 것은?
(단, 리스트의 시작 주소를 나타내는 포인터는 start이며 노드의 연결포인터 필드는 link이다)
p = start;
q = NULL;
while (p != NULL) { 
          ㉠      
    p = p->link; 
    q->link = r; 
}
start = q;
자료구조론
  1. ①q = q->link; r = q;
  2. ②r = q; q = p;
  3. ③r = q; q = p->link;
  4. ④q = q->link;
정답 보기

정답 ② · 해설 보기

5.
크기가 11인 해시 테이블이 있고, 해시함수로 h(k) = k mod 11을 사용한다. 여기서 mod는 모듈로(modulo) 함수를 의미한다. 하나의 해시 값에 대해 두 개씩의 슬롯이 할당되어 있고, 오버플로가 발생하면 다음의 빈 슬롯에 저장하는 선형 조사법(linear probe)을 사용한다고 하자. 데이터가 다음과 같은 순서로 입력된다고 할 때, 원래 계산된 슬롯에 저장되지 않는 데이터의 개수는?
54, 27, 70, 55, 13, 2, 37, 23, 33, 44, 45, 77, 56, 6, 9
자료구조론
  1. ①3
  2. ②4
  3. ③5
  4. ④6
정답 보기

정답 ② · 해설 보기

6.
C 언어를 사용하여 연결리스트를 구현할 때, 관련이 없는 것은?
자료구조론
  1. ①비트단위 논리곱
  2. ②자기참조 구조체
  3. ③동적 메모리 할당
  4. ④포인터
정답 보기

정답 ① · 해설 보기

7.
다음은 빈 상태의 힙(heap) 배열에 1 ~ 8까지의 키 순서로 삽입이 이루어질 때, 힙이 형성되는 과정을 순서대로 나타낸 그림이다. 빈 칸들에 알맞은 것은?
1
2 1
3 1 2
4 3 2 1
5 4 2 1 3
( )
7 4 6 1 3 2 5
( )
자료구조론
  1. ①(6 4 1 5 3 2), (8 7 6 4 3 2 5 1)
  2. ②(6 4 5 1 2 3), (8 7 6 4 3 5 2 1)
  3. ③(6 4 5 1 3 2), (8 7 6 3 4 2 5 1)
  4. ④(6 4 5 1 3 2), (8 7 6 4 3 2 5 1)
정답 보기

정답 ④ · 해설 보기

8.
다음 중 트리에 대한 설명으로 옳은 것은?
자료구조론
  1. ①루트 노드가 많은 트리일수록 좋은 트리이다.
  2. ②트리와 관련된 알고리즘을 재귀적인 방식으로 구현하면 실행시간이 빨라진다.
  3. ③트리의 최대레벨과 트리의 높이와는 무관하다.
  4. ④트리의 노드 중 차수(degree)가 0인 노드를 리프(leaf) 노드라고 한다.
정답 보기

정답 ④ · 해설 보기

9.
n개의 식별자 (a1, a2, …, an)로 구성된 이진탐색트리에 n + 1개의 외부 노드를 추가하여 확장 이진트리를 만들 수 있다. 각 ai의 탐색 확률이 pi이고, 각 외부 노드에 속하는 식별자, 즉 내부 노드에 있지 않은 식별자의 탐색 확률이 qi일 때 주어진 이진탐색트리 T의 전체비용은 다음 식과 같다.
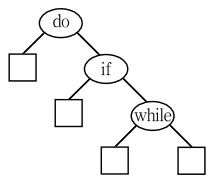
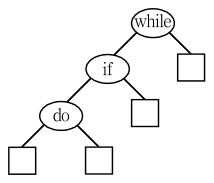
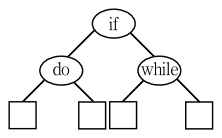
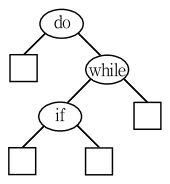
전체 비용이 최소인 이진탐색트리를 최적 이진탐색트리라 한다. 3개의 식별자가 (a1, a2, a3) = (do, if, while)이고, (p1, p2, p3) = (0.1, 0.2, 0.5), (q0, q1, q2, q3) = (0.05, 0.05, 0.05, 0.05)일 때, 최적 이진탐색트리는?
자료구조론
  1. ①
  2. ②
  3. ③
  4. ④
정답 보기

정답 ② · 해설 보기

10.
어떤 산술식을 표현한 이진트리에서 전위 순회를 한 결과가 -*AB/*CDE 이었다. 이 이진트리에서 후위 순회한 결과는?
자료구조론
  1. ①AB*CD*E/-
  2. ②AB*C*DE/-
  3. ③AB*CDE*/-
  4. ④ABC*D*E/-
정답 보기

정답 ① · 해설 보기

11.
다음 코드의 시간 복잡도를 바르게 나타낸 것은?
for (i = 1; i <= n; i++)
    for (j = 1; j <= n; j = j + i)
        for (k = 1; k <= n; k++)
            x = x + k + 1;
자료구조론
  1. ①
  2. ②
  3. ③
  4. ④
정답 보기

정답 ② · 해설 보기

12.
다음은 알고리즘의 복잡도 X를 위한 정의다. 어떤 복잡도에 대한 정의인가?
정의 : f(n)=X(g(n))
모든 n (n≥n0)에 대해 f(n)≤cg(n)을 만족하는 두 양의 상수 c와 n0가 존재하면 f(n)=X(g(n))이다.
자료구조론
  1. ①O (big oh)
  2. ②Ω (omega)
  3. ③Γ (gamma)
  4. ④Θ (theta)
정답 보기

정답 ① · 해설 보기

13.
m * n 크기의 정수 값 희소행렬을 정수형 배열에 저장하고자 한다. 가장 효과적인 저장방법을 사용할 때, 필요한 배열의 크기는?
(단, t는 0이 아닌 희소행렬 원소의 개수이며, 배열의 크기는 배열 원소의 수를 의미한다)
자료구조론
  1. ①m * n
  2. ②t
  3. ③m + n + t
  4. ④3t
정답 보기

정답 ④ · 해설 보기

14.
정렬에 대한 설명으로 옳지 않은 것은?
자료구조론
  1. ①배열에 저장되어 있는 자료들을 정렬할 경우, 합병정렬은 힙정렬보다 메모리 공간을 더 필요로 한다.
  2. ②합병정렬로 n개의 자료를 정렬할 때, 정렬된 입력이나 그렇지 않은 입력이나 걸리는 시간은 항상 이다.
  3. ③배열에 저장되어 있는 n개의 자료를 정렬하는 선택정렬에서, 최악의 경우 자료 비교횟수는 이고 최악의 경우 배열에서의 자료이동 횟수도 이다.
  4. ④정렬된 입력에 대하여 퀵정렬(첫 번째 원소를 기준으로 분할)은 힙정렬보다 시간이 많이 걸린다.
정답 보기

정답 ③ · 해설 보기

15.
행우선(Row major)으로 배열의 값을 저장하는 C 언어에서 3차원 배열 A[4][2][3]을 선언하였다. A[0][0][0]부터 A[3][1][2]에 정수 값 1 ~ 24를 행우선 순서에 따라 차례대로 저장할 때, A[2][1][2]에 저장되는 값은?
자료구조론
  1. ①17
  2. ②18
  3. ③19
  4. ④20
정답 보기

정답 ② · 해설 보기

16.
2 원 합병정렬에서 런(run)의 크기가 다를 경우, 런의 병합 순서에 따라 실행 속도의 차이가 발생한다. 초기 런의 수가 5개이며 각 런의 크기가 아래와 같을 때, 5개의 런을 하나로 병합하는 최소 시간은?
(단, 크기가 a, b인 두 개의 런을 병합하는 시간은 a + b라고 가정한다)
런 이름
r1
r2
r3
r4
r5
크기
2
4
5
7
8
자료구조론
  1. ①26
  2. ②58
  3. ③84
  4. ④88
정답 보기

정답 ② · 해설 보기

17.
메소드 호출 xxx(5)에서 반환되는 결과는?
public static int xxx(int n) {
    if (n == 0)
        return 4;
    return 1 + xxx(n - 1);
}
자료구조론
  1. ①0
  2. ②4
  3. ③5
  4. ④9
정답 보기

정답 ④ · 해설 보기

18.
그래프의 깊이우선탐색에 대한 설명으로 옳지 않은 것은?
자료구조론
  1. ①그래프의 연결 요소를 구하기 위해 깊이우선탐색을 사용할 수 있다.
  2. ②연결 그래프의 신장트리를 구하기 위해 깊이우선탐색을 사용할 수 있다.
  3. ③최소비용 신장트리를 구하는 Kruskal 알고리즘은 깊이우선탐색을 사용한다.
  4. ④그래프의 임의의 노드에서 깊이우선탐색을 시작할 수 있다.
정답 보기

정답 ③ · 해설 보기

19.
다음 중 큐(queue)에 대한 설명으로 옳은 것은?
자료구조론
  1. ①큐의 크기는 항상 미리 정해져 있어야 한다.
  2. ②자료의 삽입과 삭제는 같은 끝에서 일어난다.
  3. ③자료의 입출력은 LIFO(Last-In-First-Out) 순서로 일어난다.
  4. ④자료의 삽입과 삭제는 모두 O(1) 시간에 수행된다.
정답 보기

정답 ④ · 해설 보기

20.
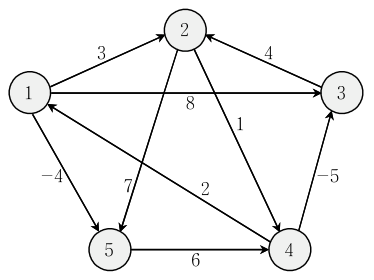
그래프에서 모든 정점 간의 최단 경로 비용을 구하기 위한 플로이드-워샬 알고리즘은 아래의 식으로 표현된다.
,
위의 식에서 는 정점 에서 정점 로 가는 간선의 가중치를 나타내며, 는 보다 더 큰 인덱스를 갖는 정점을 통과하지 않으면서 에서 까지 갈 수 있는 최단 경로 비용을 나타낸다. 아래 그래프에 대해 행렬 의 값으로 알맞은 것은?
자료구조론
  1. ①
  2. ②
  3. ③
  4. ④
정답 보기

정답 ③ · 해설 보기