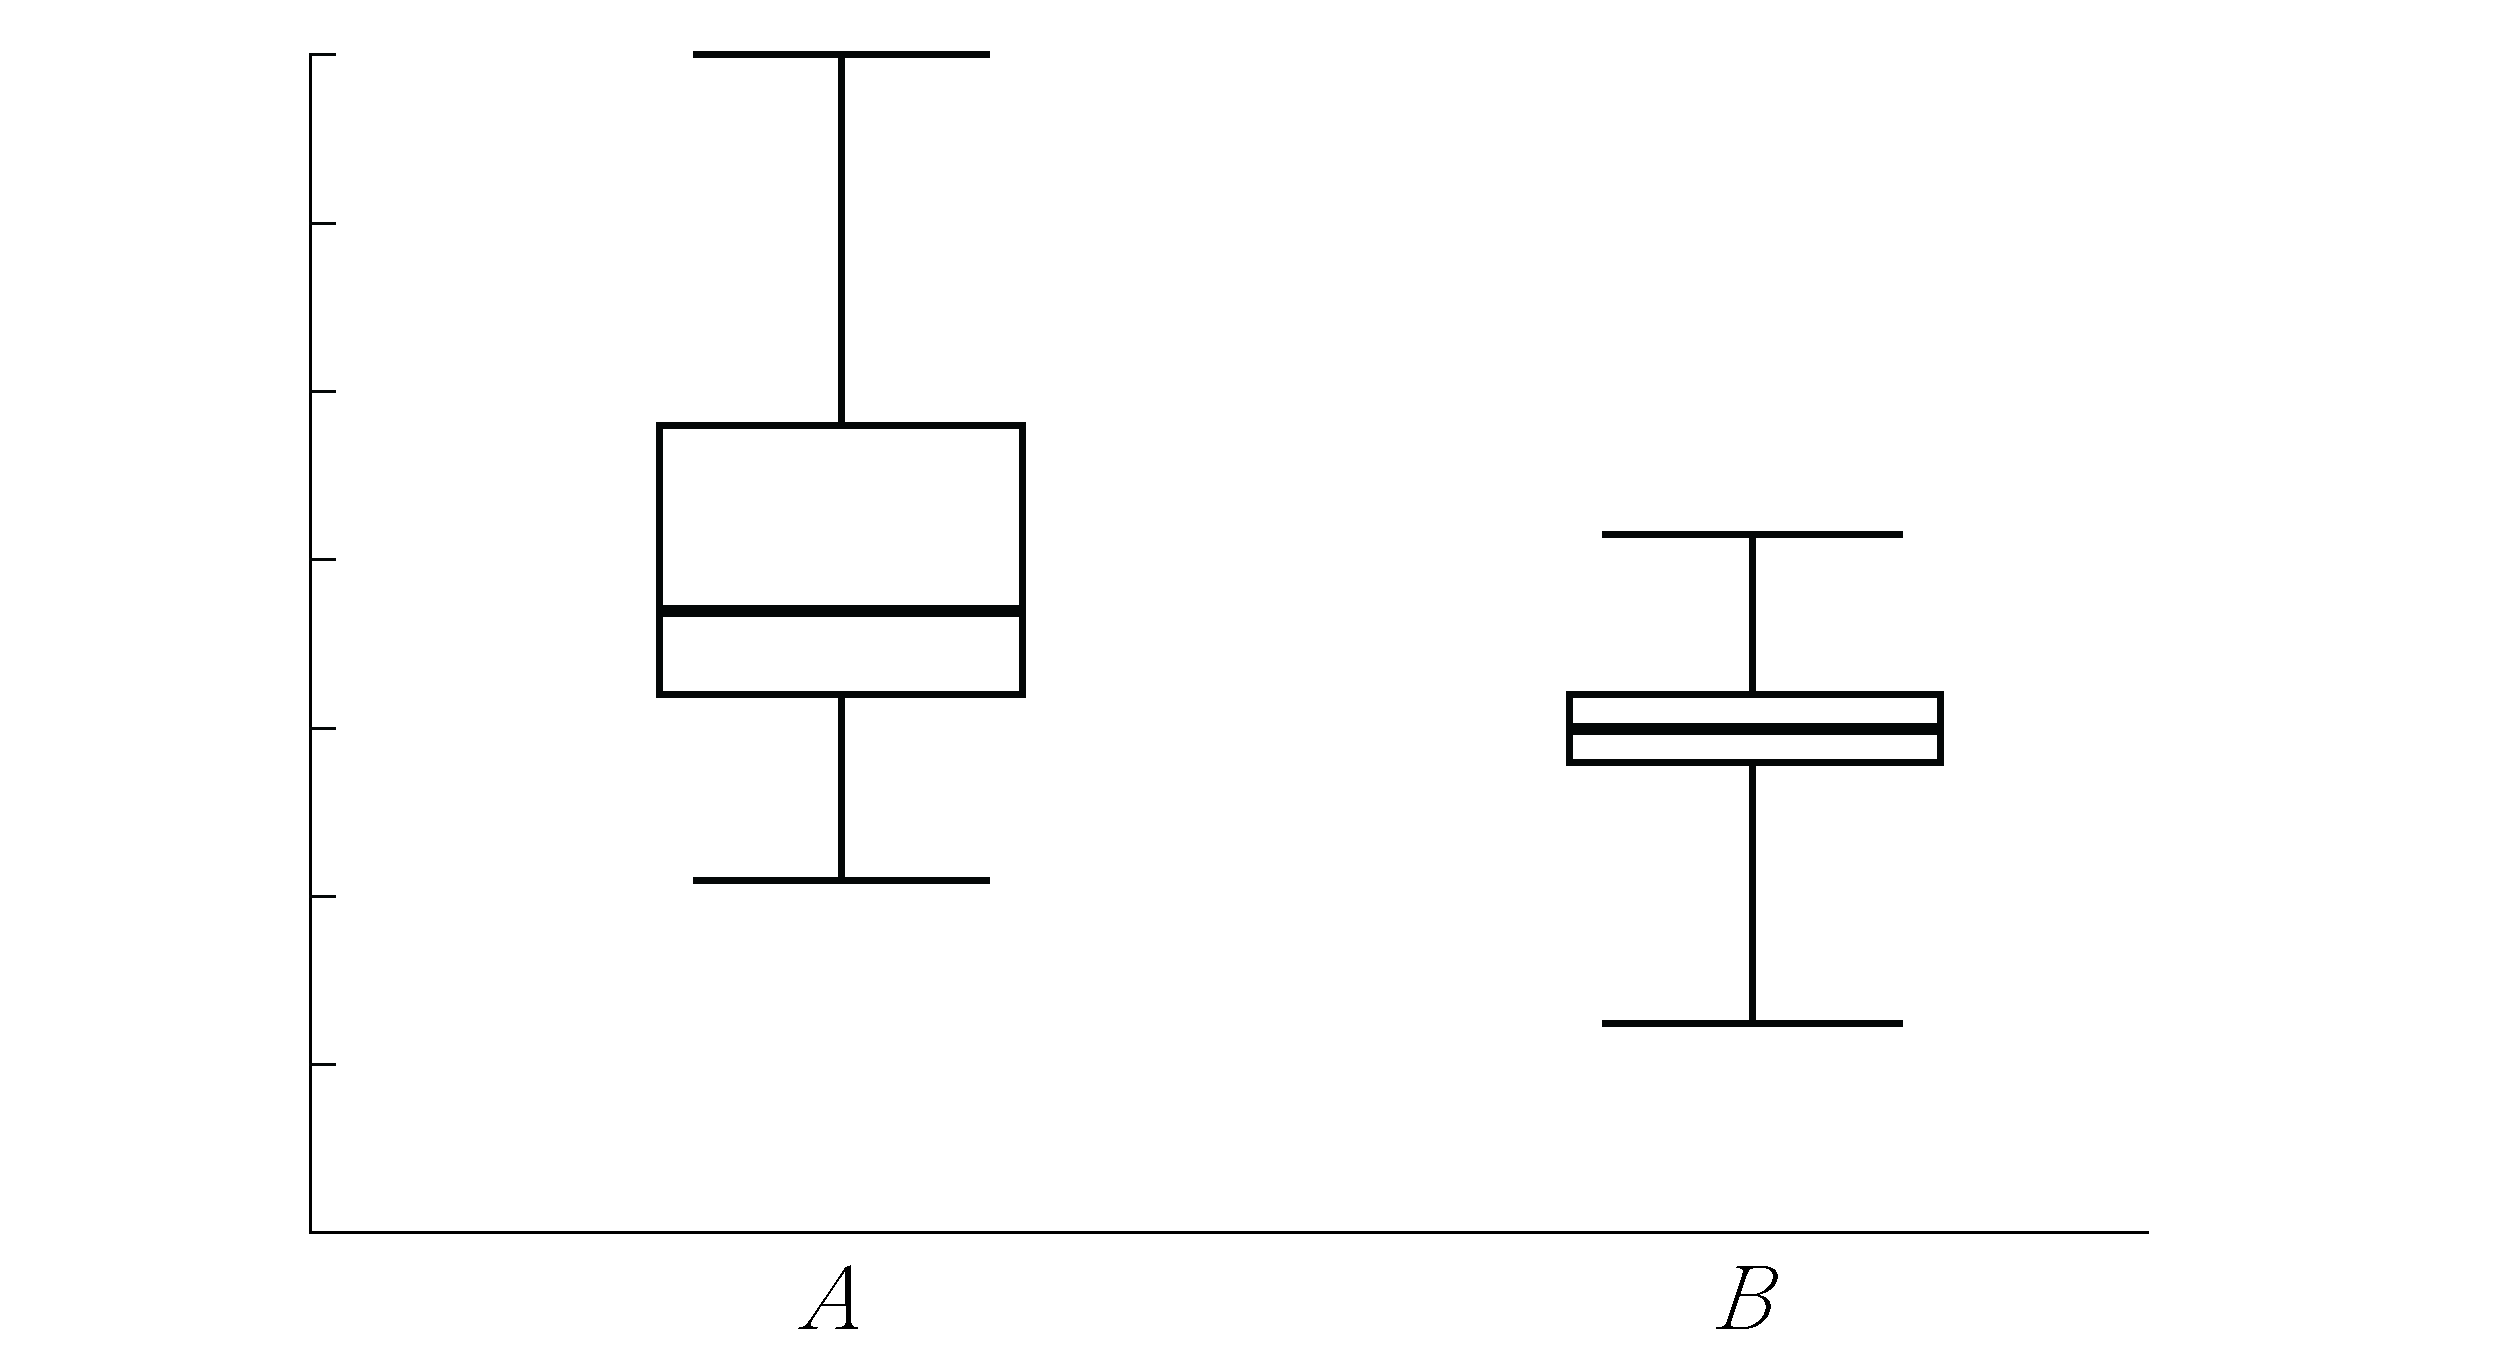1. 두 지역 A B
ㄱ. 최솟값은 A B
ㄴ. 중앙값은 A B
ㄷ. 범위는 A B
통계학개론 ① ㄱ, ㄴ ② ㄱ, ㄷ ③ ㄴ, ㄷ ④ ㄱ, ㄴ, ㄷ 정답 보기 정답 ① · 해설 보기
2. 다음 제시된 두 변수 X Y X Y
통계학개론 ① ② ③ ④ 정답 보기 정답 ③ · 해설 보기
3. 통계적 가설검정에서 제1종 오류확률에 대한 설명으로 옳은 것은?
통계학개론 ① 귀무가설이 참일 때 귀무가설을 기각할 확률 ② 귀무가설이 참일 때 귀무가설을 기각하지 않을 확률 ③ 귀무가설이 거짓일 때 귀무가설을 기각할 확률 ④ 귀무가설이 거짓일 때 귀무가설을 기각하지 않을 확률 정답 보기 정답 ① · 해설 보기
4. 단순선형회귀모형 Y i = β 0 + β 1 x i + ϵ i ( i = 1 , 2 , ⋯ , 22 ) σ 2 ϵ i N ( 0 , σ 2 )
통계학개론 ① 100 ② 105 ③ 110 ④ 120 정답 보기 정답 ② · 해설 보기
5. 코로나바이러스 감염 상황과 진단키트의 진단 확률이 다음과 같을 때, 한 사람의 진단키트 결과가 음성이라면 이 사람이 실제 음성일 확률은?
○ 전체 인구 중 코로나바이러스 양성은 20 %이다.
○ 진단키트에서 실제 음성인 사람을 음성으로 판단할 확률이 70 %이다.
○ 진단키트에서 실제 양성인 사람을 양성으로 판단할 확률이 80 %이다.
통계학개론 ① ② ③ ④ 정답 보기 정답 ③ · 해설 보기
6. 두 연속형 확률변수 X Y
통계학개론 ① X Y ② X Y X Y ③ X Y X Y ④ X Y X 정답 보기 정답 ④ · 해설 보기
7. 다음은 단순선형회귀모형을 적합하여 얻은 분산분석표이다.
요인
제곱합
자유도
평균제곱
F
회귀
540
(가)
(다)
잔차
200
(나)
계
740
11
이에 대한 설명으로 옳지 않은 것은?
통계학개론 ① (가)의 값은 540이다. ② (나)의 값은 20이다. ③ (다)의 값은 27이다. ④ 정답 보기 정답 ④ · 해설 보기
8. 다음은 시장조사에서 세탁기 색에 대한 선호도를 알아보기 위해 최근 판매된 세탁기의 색을 조사한 결과이다.
색
흰색
검은색
상아색
회색
합계
빈도
40
24
10
6
80
선호하는 색이 4 : 4 : 1 : 1의 비율로 분포한다는 가설을 검정하려 할 때, 이에 대한 설명으로 옳은 것만을 모두 고르면?
ㄱ. 검정통계량은 5이다.
ㄴ. 검정통계량의 자유도는 4이다.
ㄷ. 검은색의 기대도수는 32이다.
통계학개론 ① ㄱ, ㄴ ② ㄱ, ㄷ ③ ㄴ, ㄷ ④ ㄱ, ㄴ, ㄷ 정답 보기 정답 ② · 해설 보기
통계학개론 ① 확률변수 F ( d f 1 , d f 2 ) F F 1 ( d f 2 , d f 1 ) F ② 평균이 μ σ 2 n X N ( μ , n σ 2 ) ③ 확률변수 X 1 , X 2 , ⋯ , X n X 1 2 + X 2 2 + ⋯ + X n 2 n ④ 평균이 μ σ 2 X Z = σ / n X − μ 정답 보기 정답 ④ · 해설 보기
10. 세 가지 필터의 성능을 비교하기 위해 일원배치 분산분석법(one-way analysis of variance)을 실시하여 얻은 분산분석표의 일부가 다음과 같을 때 (가)의 값은?
요인
제곱합
자유도
평균제곱
F
처리
50
(가)
오차
20
6
계
70
통계학개론 ① 2.5 ② 5.0 ③ 7.5 ④ 15.0 정답 보기 정답 ③ · 해설 보기
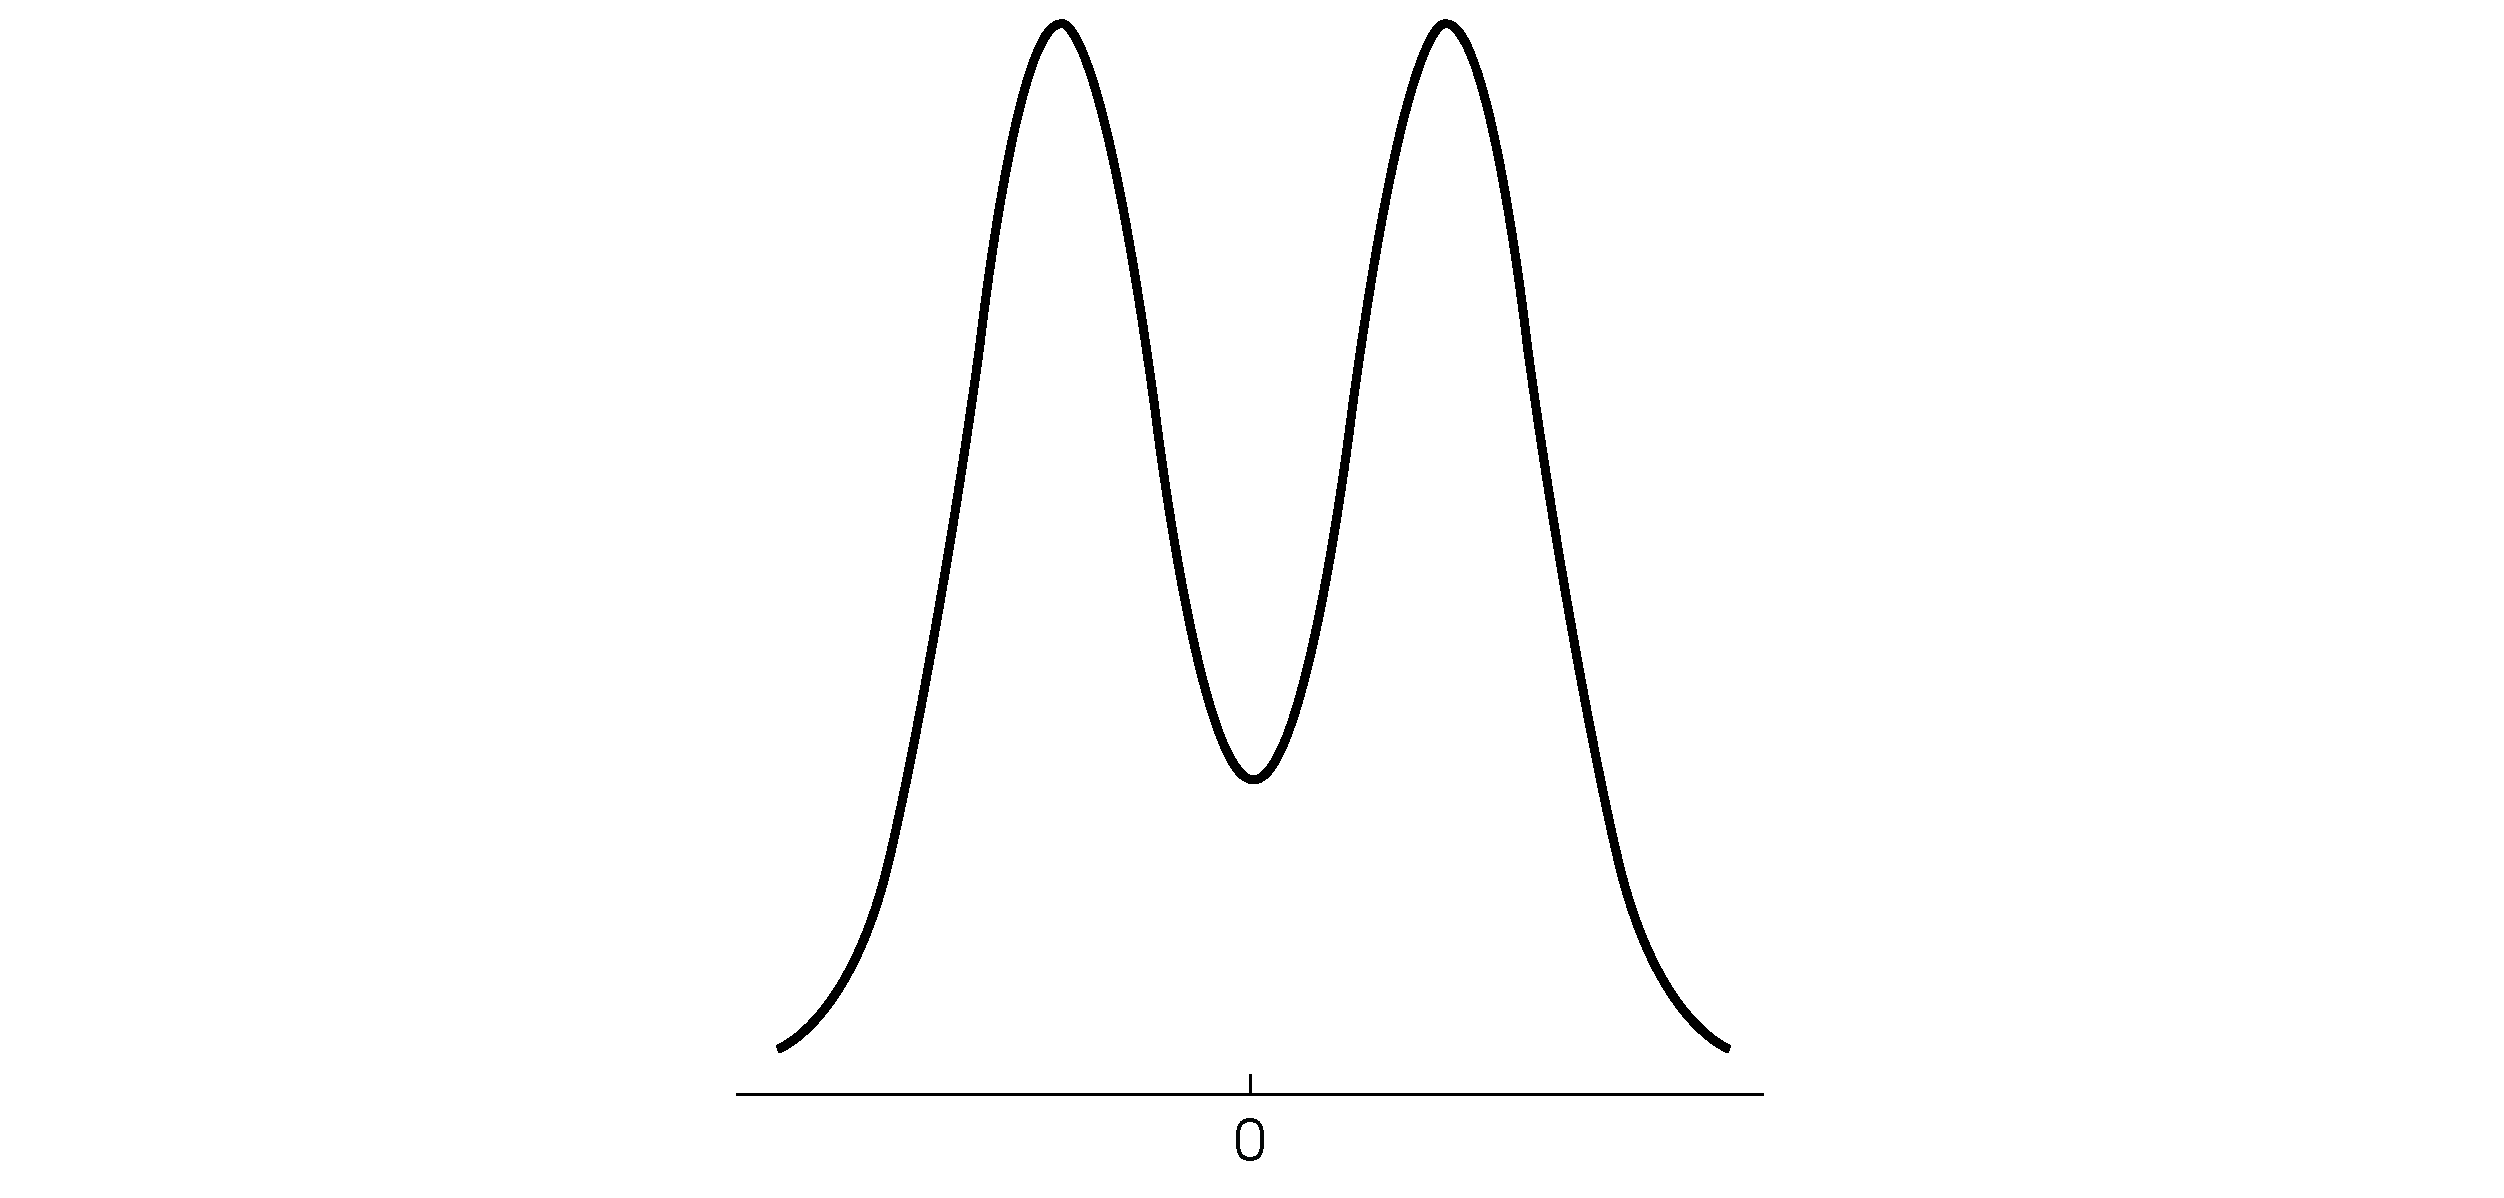
11. 다음은 어느 확률변수의 확률밀도함수이다. 이에 대한 설명으로 옳은 것만을 모두 고르면? (단, 함수는 0을 기준으로 좌우 대칭이다)
ㄱ. 평균은 0이다.
ㄴ. 중앙값은 0이다.
ㄷ. 최빈값의 절댓값은 중앙값보다 크다.
통계학개론 ① ㄱ ② ㄱ, ㄴ ③ ㄴ, ㄷ ④ ㄱ, ㄴ, ㄷ 정답 보기 정답 ④ · 해설 보기
12. 어느 지역에서 20대 남자의 몸무게는 평균이 μ 8 μ Z P ( Z ≥ 1.96 ) = 0.025 P ( Z ≥ 1.645 ) = 0.05
통계학개론 ① (64.040, 67.960) ② (64.355, 67.645) ③ (65.755, 66.245) ④ (65.794, 66.206) 정답 보기 정답 ① · 해설 보기
13. 다중선형회귀모형 Y i = β 0 + β 1 x i 1 + β 2 x i 2 + ϵ i ( i = 1 , 2 , ⋯ , n ) F p ϵ i N ( 0 , σ 2 )
통계학개론 ① β 1 = 0 β 2 = 0 ② β 1 = 0 β 2 = 0 ③ β 0 = 0 β 1 = 0 β 2 = 0 ④ β 0 = 0 β 1 = 0 β 2 = 0 정답 보기 정답 ② · 해설 보기
14. 확률변수 X V a r ( 3 X + 9 ) = 36 E ( X ( X + 1 )) = 10 E ( X ) E ( X ) > 0
통계학개론 ① 1 ② 2 ③ 3 ④ 4 정답 보기 정답 ② · 해설 보기
15. 독립인 두 모집단 1과 2에 대한 확률분포는 각각 다음과 같다.
구분
x
0
1
2
모집단 1
P ( X 1 = x )
3 2
3 1
0
모집단 2
P ( X 2 = x )
0
3 1
3 2
모집단 i X i X 1 + X 2
통계학개론 ① N ( 2 , 900 2 ) ② N ( 2 , 900 4 ) ③ N ( 4 , 900 2 ) ④ N ( 4 , 900 4 ) 정답 보기 정답 ② · 해설 보기
16. 모평균과 모분산이 알려지지 않고 서로 독립인 두 개의 정규모집단에서 각각 25개씩 표본을 임의추출한 후, 두 모집단의 모분산을 비교할 때 사용하는 분포는?
통계학개론 ① 표준정규분포 ② 자유도가 24 t ③ 자유도가 24 ④ 자유도가 ( 24 , 24 ) F 정답 보기 정답 ④ · 해설 보기
17. 성별과 와인 생산지의 선호도가 관련이 있는지를 알아보기 위해 100명을 임의추출한 후 성별과 와인 생산지 선호도를 조사하여 작성한 분할표가 다음과 같다.
프랑스
칠레
미국
행의 합
남
x 11
x 12
x 13
R 1 ∙
여
x 21
x 22
x 23
R 2 ∙
열의 합
C ∙ 1
C ∙ 2
C ∙ 3
성별과 와인 생산지 선호도가 관련이 있는지를 검정하는 카이제곱검정통계량의 값은?
통계학개론 ① ∑ i = 1 2 ∑ j = 1 3 ( x ij − ( 100 R i ∙ × C ∙ j ) ) ÷ ( 100 R i ∙ × C ∙ j ) ② ∑ i = 1 2 ∑ j = 1 3 ( x ij − ( 100 R i ∙ × C ∙ j ) ) ÷ ( 100 R i ∙ × C ∙ j ) 2 ③ ∑ i = 1 2 ∑ j = 1 3 ( x ij − ( 100 R i ∙ × C ∙ j ) ) 2 ÷ ( 100 R i ∙ × C ∙ j ) ④ ∑ i = 1 2 ∑ j = 1 3 ( x ij − ( 100 R i ∙ × C ∙ j ) ) 2 ÷ ( 100 R i ∙ × C ∙ j ) 2 정답 보기 정답 ③ · 해설 보기
18. 다음은 서로 독립인 두 지역 A B A B
A
B
표본평균
38
41
표본표준편차
8
10
A μ A B μ B H 0 : μ A = μ B H 1 : μ A = μ B p Z
통계학개론 ① P ( ∣ Z ∣ ≥ 200 1 0 2 + 100 8 2 41 − 38 ) ② P ( Z ≥ 200 1 0 2 + 100 8 2 41 − 38 ) ③ P ( ∣ Z ∣ ≤ 200 1 0 2 + 100 8 2 41 − 38 ) ④ P ( Z ≤ 200 1 0 2 + 100 8 2 41 − 38 ) 정답 보기 정답 ① · 해설 보기
19. 다음은 두 인자 A B
요인
제곱합
자유도
평균제곱
F
p
인자 A
700
1
0.011
인자 B
900
3
0.040
교호작용 A × B
1,200
(가)
(나)
0.034
오차
800
8
통계학개론 ① (가)는 3이고 (나)는 4이다. ② 분석에 사용한 자료의 수는 모두 15개이다. ③ 인자 A B ④ 인자 A 정답 보기 정답 ② · 해설 보기
20. 정규분포로부터 임의추출한 자료의 정규확률그림(정규분포 분위수대분위수 그림, normal probability plot)은?
통계학개론 ① ② ③ ④ 정답 보기 정답 ③ · 해설 보기