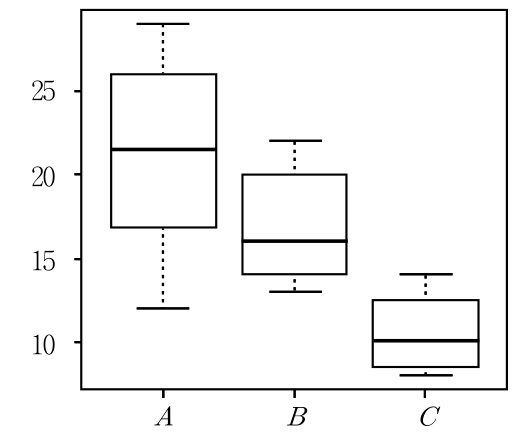
1. 어느 회사의 기계 A B C
통계학개론 ① 최댓값은 A C ② 범위(range)는 A B ③ 중앙값(median)의 크기는 A > B > C ④ B Q 3 A Q 1 정답 보기 정답 ④ · 해설 보기
2. 두 이산확률변수 X Y X Y
X
Y
-2
0
2
0
0
3 1
0
1
3 1
0
3 1
통계학개론 ① 0 ② 3 1 ③ 3 2 ④ 1 정답 보기 정답 ① · 해설 보기
3. 어느 볼펜 제조 공장에서 100개의 표본을 임의로 추출하여 불량 여부를 조사한 결과 12개가 불량품이었다. 이항분포의 정규분포근사를 이용하여 불량품의 비율에 대한 95 % 신뢰구간을 구한 것은? (단, Z P ( ∣ Z ∣ < 1.645 ) = 0.90 P ( ∣ Z ∣ < 1.96 ) = 0.95
통계학개론 ① 100 12 ± 1.96 100 12 × ( 1 − 100 12 ) ② 100 12 ± 1.96 100 100 12 × ( 1 − 100 12 ) × 1 ③ 100 12 ± 1.645 100 12 × ( 1 − 100 12 ) ④ 100 12 ± 1.645 100 100 12 × ( 1 − 100 12 ) × 1 정답 보기 정답 ② · 해설 보기
4. X 1 X 2 X 3 μ μ
Y 1 = 3 X 1 + X 2 + X 3 , Y 2 = 3 2 X 1 + X 2 , Y 3 = X 3
통계학개론 ① Y 1 ② Y 1 , Y 2 ③ Y 1 , Y 3 ④ Y 1 , Y 2 , Y 3 정답 보기 정답 ④ · 해설 보기
5. 확률변수 X Y X Y
통계학개론 ① 2 X + 1 ② X + 2 2 Y + 1 ③ X − Y ④ 2 X + Y 정답 보기 정답 ④ · 해설 보기
6. X 1 , X 2 , ⋯ , X n P ( X ≤ 4 + 5 y ) = 0.5 y n X = n 1 ∑ i = 1 n X i
통계학개론 ① − 5 4 ② 0 ③ 5 4 ④ 1 정답 보기 정답 ② · 해설 보기
7. 확률변수 X E ( 2 X − 3 ) = p E [ ( 2 X − 3 ) 2 ] = q p + q
통계학개론 ① 0 ② 1 ③ 2 ④ 3 정답 보기 정답 ② · 해설 보기
8. 카이제곱분포에 대한 설명으로 옳은 것만을 모두 고른 것은?
ㄱ. Z Z 2
ㄴ. 서로 독립인 두 확률변수가 각각 카이제곱분포를 따를 때, 두 확률변수의 합도 카이제곱분포를 따른다.
ㄷ. 두 범주형자료의 독립성검정에서 행의 수가 3이고 열의 수가 4인 분할표(contingency table)를 이용할 때, 카이제곱검정통계량은 자유도가 12인 카이제곱분포를 따른다.
통계학개론 ① ㄱ ② ㄱ, ㄴ ③ ㄴ, ㄷ ④ ㄱ, ㄴ, ㄷ 정답 보기 정답 ② · 해설 보기
9. 다음은 어느 기관에서 세 가지 교육방법에 따른 근무평가점수의 차이를 알아보고자 반복수가 같은 일원배치 분산분석법(one-way analysis of variance)을 적용하여 얻은 분산분석표의 일부이다. 이에 대한 설명으로 옳지 않은 것은?
요인
제곱합
자유도
평균제곱
F
p
처리
㉠
㉢
㉤
잔차
㉣
계
㉡
통계학개론 ① ㉢은 2이다. ② 근무평가점수의 분산에 대한 추정값은 ㉣이다. ③ ㉡이 고정되어 있을 때, ㉠이 커지면 ㉤은 작아진다. ④ ㉤이 0.05보다 크면 유의수준 5 %에서 세 가지 교육방법에 따른 근무평가점수는 차이가 있다고 할 수 있다. 정답 보기 정답 ④ · 해설 보기
10. 평균이 172이고 분산이 100인 정규모집단에서 10개의 표본을 임의로 추출할 때, 모평균보다 큰 표본의 수를 확률변수 X X
통계학개론 ① 1 ② 2 5 ③ 10 ④ 10 정답 보기 정답 ② · 해설 보기
11. 사건 A A B A B B
통계학개론 ① 0.24 ② 0.4 ③ 0.5 ④ 0.6 정답 보기 정답 ② · 해설 보기
12. 확률변수 X Y X Y 2 X + 1 Y − 5
통계학개론 ① − 3 2 ② − 3 1 ③ 3 1 ④ 3 2 정답 보기 정답 ① · 해설 보기
13. 평균이 μ μ A B A B
통계학개론 ① 4 1 ② 2 1 ③ 2 ④ 4 정답 보기 정답 ② · 해설 보기
14. 절편이 있는 단순선형회귀분석에서 결정계수(coefficient of determination)에 대한 설명으로 옳지 않은 것은?
통계학개론 ① 항상 0보다 크거나 같고 1보다 작거나 같다. ② 종속변수와 독립변수 사이의 표본상관계수 제곱과 같다. ③ 종속변수의 분산에 대한 불편추정량(unbiased estimator)이다. ④ 총변동(total sum of squares) 중에서 추정된 회귀식에 의해 설명되는 변동(regression sum of squares)의 비율을 나타낸다. 정답 보기 정답 ③ · 해설 보기
15. X 1 , X 2 , ⋯ , X n X = n 1 ∑ i = 1 n X i S 2 = n − 1 1 ∑ i = 1 n ( X i − X ) 2 a b a + b
통계학개론 ① 3 ② 4 ③ 5 ④ 6 정답 보기 정답 ③ · 해설 보기
16. 분산이 같고 서로 독립인 두 정규모집단 A B A B X 1 , X 2 , ⋯ , X n X = n 1 ∑ i = 1 n X i S 2 = n − 1 1 ∑ i = 1 n ( X i − X ) 2
통계학개론 ① 16 ② 25 ③ 36 ④ 49 정답 보기 정답 ③ · 해설 보기
17. 다음은 단순선형회귀모형 Y i = β 0 + β 1 X i + ϵ i i = 1 , 2 , ⋯ , n ϵ i σ 2
요인
제곱합
자유도
평균제곱
F
p
회귀
20
0.0064
잔차
30
15
통계학개론 ① F ② 표본의 크기 n ③ 종속변수와 독립변수 사이의 표본상관계수는 0.4이다. ④ 유의수준 5 %에서 ‘이 회귀모형은 유의하지 않다’는 귀무가설을 기각한다. 정답 보기 정답 ③ · 해설 보기
18. 평균이 μ σ 2 X 1 , X 2 , ⋯ , X n X = n 1 ∑ i = 1 n X i S 2 = n − 1 1 ∑ i = 1 n ( X i − X ) 2 n
통계학개론 ① S n ( X − μ ) n t ② σ X σ μ n 1 ③ ∑ i = 1 n X i n μ n σ 2 ④ σ n ( X − μ ) 정답 보기 정답 ① · 해설 보기
19. 어느 지역에서의 특정 스마트폰 모델에 대한 남녀별 선호도 차이를 알아보기 위해 남자 200명, 여자 100명을 임의로 추출하여 조사한 결과가 다음 표와 같다. 이를 검정하기 위한 Z Z
표본크기
특정 스마트폰 모델 선호자 수
남자
200
100
여자
100
40
통계학개론 ① ( 30 30 15 × 15 ) × 140 1 ∣0.5 − 0.4∣ ② ( 30 30 15 × 15 ) × 300 1 ∣0.5 − 0.4∣ ③ ( 30 30 14 × 16 ) × ( 200 1 + 100 1 ) ∣0.5 − 0.4∣ ④ 30 14 × ( 200 1 + 100 1 ) ∣0.5 − 0.4∣ 정답 보기 정답 ③ · 해설 보기
20. 반복수가 같지 않은 일원배치 분산분석법(one-way analysis of variance)에서 i j Y ij σ 2 i Y i . = n i 1 ∑ j = 1 n i Y ij Y .. = n 1 ∑ i = 1 k ∑ j = 1 n i Y ij σ 2 i = 1 , 2 , ⋯ , k j = 1 , 2 , ⋯ , n i n i > 1 n n 1 + n 2 + ⋯ + n k
통계학개론 ① n − k ∑ i = 1 k ∑ j = 1 n i ( Y ij − Y i . ) 2 ② n − k ∑ i = 1 k ∑ j = 1 n i ( Y ij − Y .. ) 2 ③ n − 1 ∑ i = 1 k ∑ j = 1 n i ( Y ij − Y i . ) 2 ④ n − 1 ∑ i = 1 k ∑ j = 1 n i ( Y ij − Y .. ) 2 정답 보기 정답 ① · 해설 보기